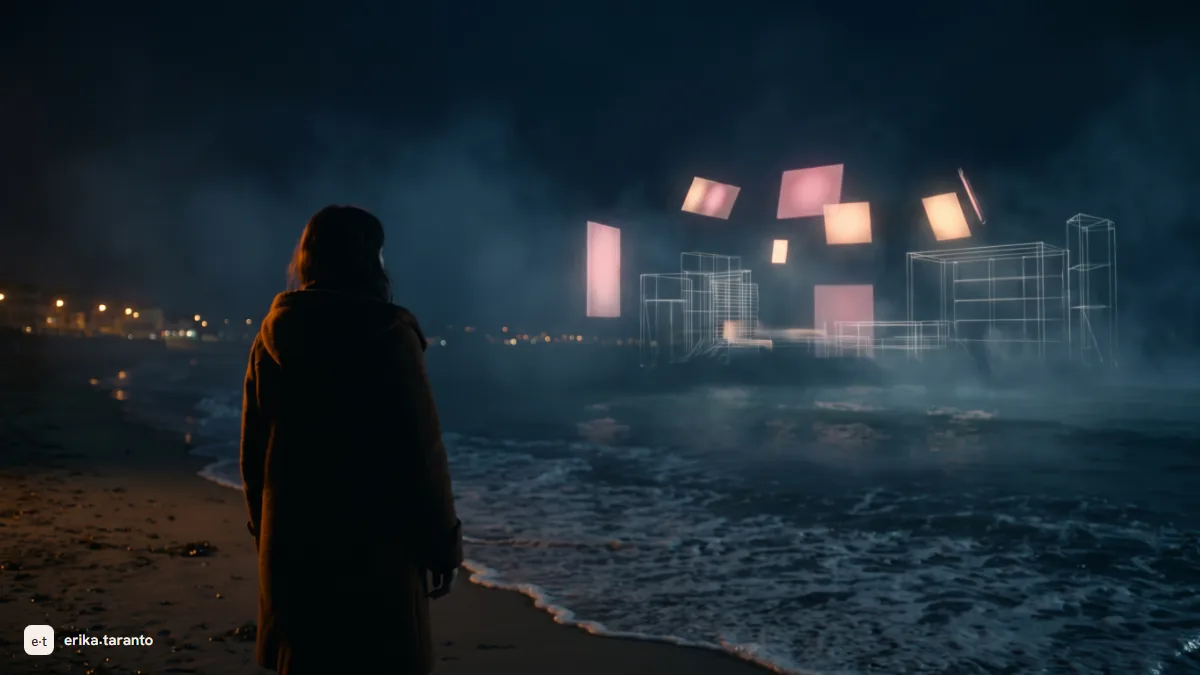
Creare video con l'AI nel 2026 funziona così: descrivi la scena (o le dai un'immagine di partenza) e il modello genera una clip di pochi secondi, con camera, movimento e, sui motori di punta, l'audio sincronizzato. Poi le clip si scelgono e si montano, come al cinema. I quattro strumenti principali sono Veo 3, Kling, Seedance e la piattaforma Higgsfield, che li ospita e ci aggiunge gli strumenti di regia. La qualità è già quella della televisione; i limiti veri sono la durata delle clip e la coerenza tra una clip e l'altra. Qui sotto trovi come funziona tutto, quanto costa e cosa puoi farci per lavoro.
Due anni fa i video generati con l'AI sembravano uno scherzo: corpi che si deformavano come cera, persone che camminavano e si scioglievano a metà strada. Oggi con gli stessi strumenti ci si producono spot pubblicitari e cortometraggi: il mio mini-film UNSEEN è arrivato tra i 10 finalisti mondiali dell'AI for Good Film Festival delle Nazioni Unite, ed è girato esattamente con gli strumenti di questa guida. Se vuoi vedere che tipo di risultati si raggiungono, qui trovi il case study completo di UNSEEN, con il dietro le quinte.
Mi chiamo Erika e di mestiere genero immagini e video con l'AI per brand e per progetti miei. Quindi niente lista di venti tool letti sui comunicati stampa: ti racconto i quattro, dove ognuno vince, dove fa fatica, e come si costruisce un video da zero, col flusso che seguo io. In fondo alla pagina trovi l'elenco delle guide dedicate, una per strumento, compresa la strada gratuita.
Come funziona la generazione video AI oggi
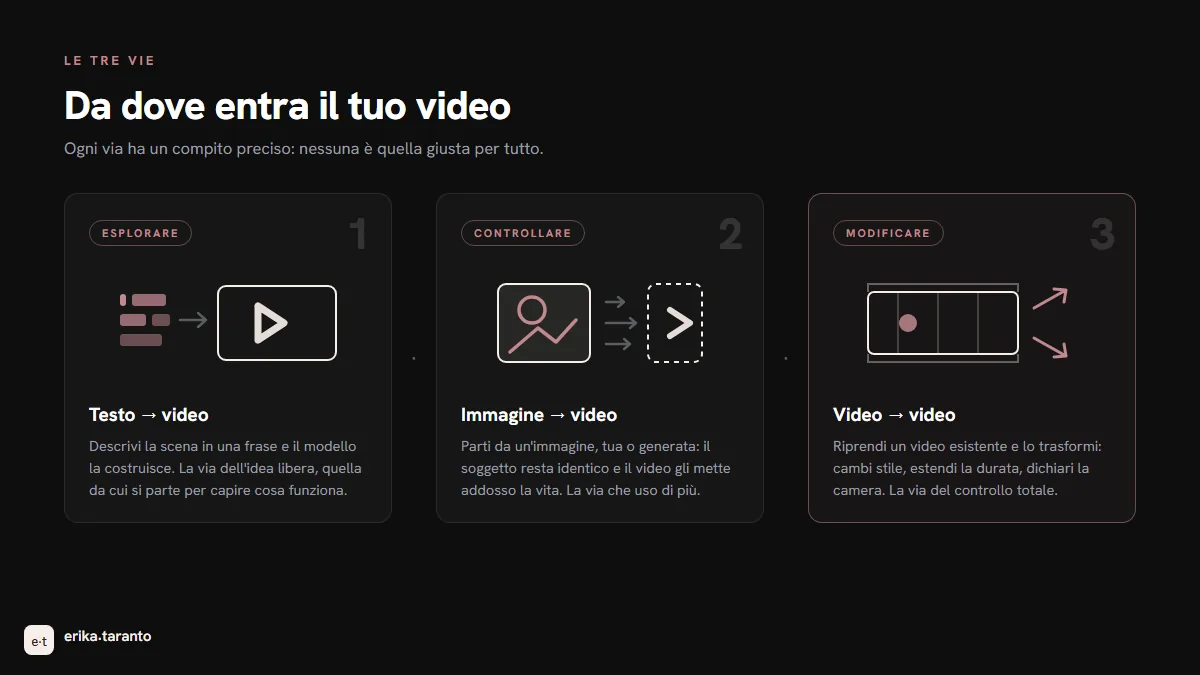
Il principio è lo stesso delle immagini, con una complicazione in più: il tempo. Un modello video deve decidere non solo come appare ogni fotogramma, ma cosa succede da un fotogramma all'altro. Per questo le vie d'ingresso sono tre.
Da testo a video (text-to-video). Scrivi la scena e il modello la gira: soggetto, azione, camera, luce. È la via che conoscono tutti, ed è ottima per esplorare idee, perché ogni frase può diventare un'inquadratura.
Da immagine a video (image-to-video). Parti da un'immagine, tua o generata con l'AI, e il modello la anima: decide il movimento dentro la scena mantenendo il punto di partenza. È la via più affidabile quando serve controllo, perché il soggetto è già lì, identico, e il modello lo anima senza doverlo reinventare. È la strada che uso di più: prima genero i fotogrammi chiave con i modelli immagine, poi li animo.
Da video a video. La terza via è la modifica di un video che hai già generato, o di un girato vero. Sul girato generato è la strada meno battuta, perché i modelli sono nati per creare, non per rimescolare. Ma nella direzione opposta, gli effetti speciali su video reali, i risultati convincono: parti da un filmato vero e ci aggiungi cieli, esplosioni, creature e magia generata con l'AI. È un metodo di lavoro a sé, con le sue regole: lo racconto in un post dedicato, appena esce.
Poi c'è il dato che cambia tutto rispetto all'anno scorso: l'audio. Veo 3 genera audio sincronizzato con la scena, dialoghi compresi. Fino a poco fa il video AI era muto e la voce si aggiungeva dopo; oggi la pioggia ha il rumore e un personaggio può parlare con le labbra che seguono le parole. Non è un dettaglio: è la differenza tra un esperimento e un prodotto.
I quattro principali (e perché)
La domanda che mi arriva ogni settimana è "qual è il migliore?". È la domanda sbagliata: sono quattro strumenti diversi, e il lavoro migliora quando smetti di cercare il vincitore e inizi ad assegnare ogni scena allo strumento che la sa fare meglio. Te li racconto uno per uno, come li uso io.
Veo 3 e Veo 3.1 (Google DeepMind) è quello che segue il prompt con la precisione maggiore. Si usa in Flow e via API (secondo la pagina di Gemini, nell'app a pagamento il suo posto l'ha preso Gemini Omni, il nuovo modello video di Google), e la versione corrente esegue le richieste come le hai scritte: chiedi una carrellata laterale con la pioggia controluce e ottieni quella scena, con la camera e la luce descritte. L'audio nativo è tra i migliori, i dialoghi reggono. È il motore da scegliere quando il video deve corrispondere esattamente a quello che hai descritto. La guida a Veo 3.
Kling (Kuaishou) è il più realista sul movimento delle persone: camminate, gesti, fisica dei corpi. È uno degli strumenti con cui ho generato le scene di UNSEEN, e resta il mio riferimento quando in scena c'è qualcuno che si muove. Il 15 ottobre 2026 Kling ha lanciato ufficialmente la versione 4.0, con clip fino a trenta secondi e audio stereo. La guida a Kling AI.
Seedance (ByteDance) è quello che interpreta meglio i prompt lunghi, con più azioni concatenate. Quando una scena contiene tre azioni in sequenza, gli altri modelli ne eseguono due e ne saltano una; Seedance le rispetta tutte. La versione 2.5, lanciata il 31 luglio 2026, allunga la durata a trenta secondi in una generazione sola e accetta fino a cinquanta riferimenti in una volta (trenta immagini, dieci video e dieci audio). Se scrivi scene, e non singole immagini in movimento, è il motore giusto. La guida a Seedance.
Higgsfield è un'altra cosa: non un modello ma una piattaforma di regia. Dentro trovi più motori, Seedance e Kling compresi, e sopra i motori gli strumenti che agli altri mancano: movimenti di camera pronti, dal carrello all'orbita, estensione delle clip, coerenza del personaggio tra una generazione e l'altra. È dove passo le mie giornate, ed è lo strumento con cui porto i progetti in concorso. La guida a Higgsfield spiega piattaforma, crediti e piani nel dettaglio; per provarla, io entro ogni giorno da higgsfield.ai.
E Sora 2? Ha chiuso: l'app e il sito sono stati spenti il 26 aprile 2026, e il 24 settembre l'API ha seguito la stessa strada. Resta il modello che ha insegnato a tutti il lavoro per progetti, lo storyboard e i cameo, e la sua storia merita di essere raccontata per come finisce: Sora 2 chiuso: alternative e cosa usare oggi.
Quale scegliere per che cosa
Questa tabella riassume quando conviene ciascuno. Cosa c'è di gratis è aggiornato ad agosto 2026, tranne la riga di Veo, ricontrollata il 16 ottobre 2026, e cambia spesso.
| Punto di forza | Gratis, oggi | Quando lo scelgo | |
|---|---|---|---|
| Veo 3 | Controllo, prompt seguiti | nessun gratuito: la generazione video in Gemini richiede un piano Google AI | Risultati fedeli al prompt |
| Kling | Realismo, movimento | nessun credito nel piano gratuito | Persone in movimento |
| Seedance | Prompt lunghi, durata | versioni di prova gratuite via Dreamina (CapCut) | Scene con più azioni |
| Higgsfield (piattaforma) | Regia, coerenza, camera | piano gratuito con pochi modelli, senza crediti | Progetti interi, da reel a cortometraggio |
Le strade serie per generare video AI senza spendere sono poche: la tabella qui sopra basta per capire quanto ci si può provare, non per lavorarci. La lista completa delle vie gratuite, raccolta e spiegata, sta nella guida dedicata: creare video AI gratis.
Nella pratica non si sceglie un tool: si costruisce una combinazione. Io genero i fotogrammi chiave con i modelli immagine, animo con lo strumento adatto alla scena, e tengo insieme il progetto dentro una piattaforma di regia, dove la coerenza del personaggio e la camera restano stabili da una clip all'altra.
Creare un video con l’AI, passo per passo
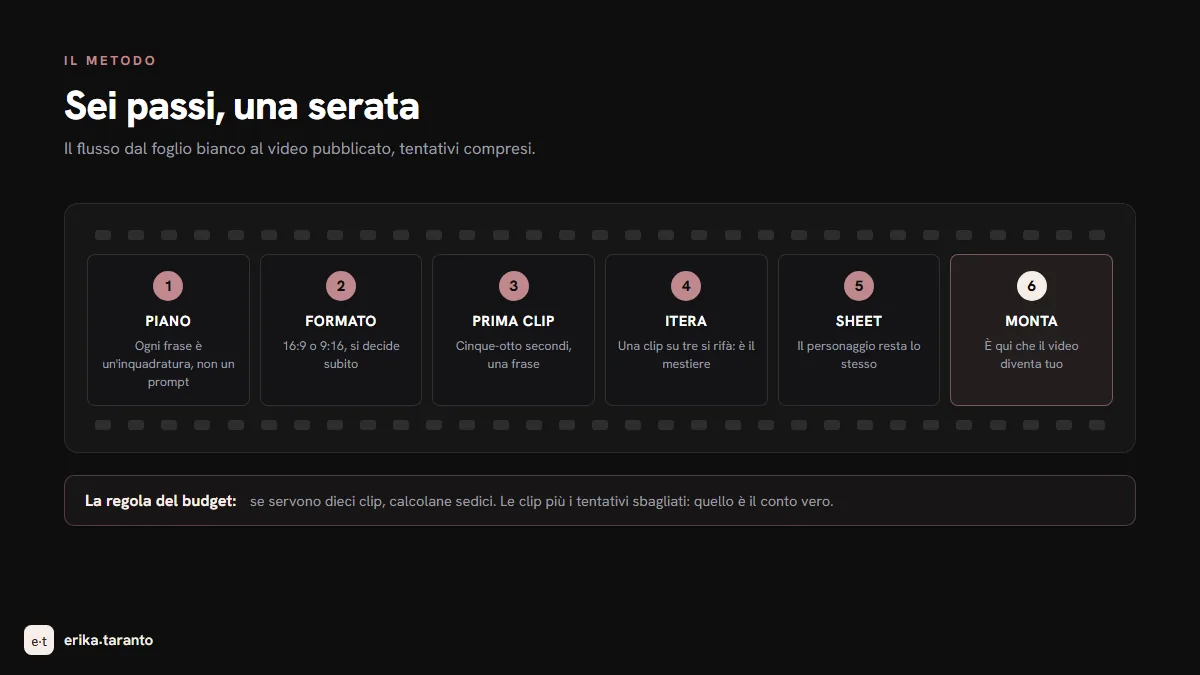
Il flusso che seguo io, dal foglio bianco al video pubblicato. Te lo mostro per intero, tentativi compresi:
- Scrivi il piano, non il prompt. Prima di toccare qualunque tool, divido il video in frasi: ogni frase è un'inquadratura. "Una donna cammina sul bagnasciuga di notte" è una clip. "L'insegna del bar si riflette nella pozzanghera" è un'altra. Un reel da trenta secondi sono sei-otto frasi.
- Scegli il formato subito. Orizzontale 16:9 per YouTube e il sito, verticale 9:16 per reel e Stories. Cambiarlo dopo costa rigenerare tutto, perché l'inquadratura nasce nel formato.
- Genera la prima clip. Un prompt di cinque-otto secondi, uno per frase. Il primo colpo quasi mai basta.
- Rigenera le clip che non reggono. Camera che vaga, fisica che crolla, dettaglio che cambia: nella mia media una clip su tre va rifatta. È il costo normale del mestiere, non un fallimento.
- Mantieni il personaggio coerente. Se nel video c'è un volto che deve restare lo stesso, il metodo è generare prima uno sheet del personaggio: una serie di immagini della stessa persona in vari punti di vista, da lontano, il viso da vicino, di lato, di tre quarti. Da lì in poi ogni clip parte da quelle immagini come riferimento, e il personaggio resta riconoscibile da una scena all'altra. Saltare questo passaggio è il motivo numero uno per cui il personaggio cambia faccia a metà video.
- Monta. Le clip entrano sulla timeline, si tagliano sul ritmo, si aggiunge l'audio. Nessun modello ti dà il montaggio: è qui che il video diventa tuo.
- Verifica i dettagli da vicino. Mani, testi, oggetti che si trasformano. Il video AI va rivisto con calma: la sorpresa bella c'è anche, ma non si pubblica a occhi chiusi.
Come si scrive un prompt video che funziona
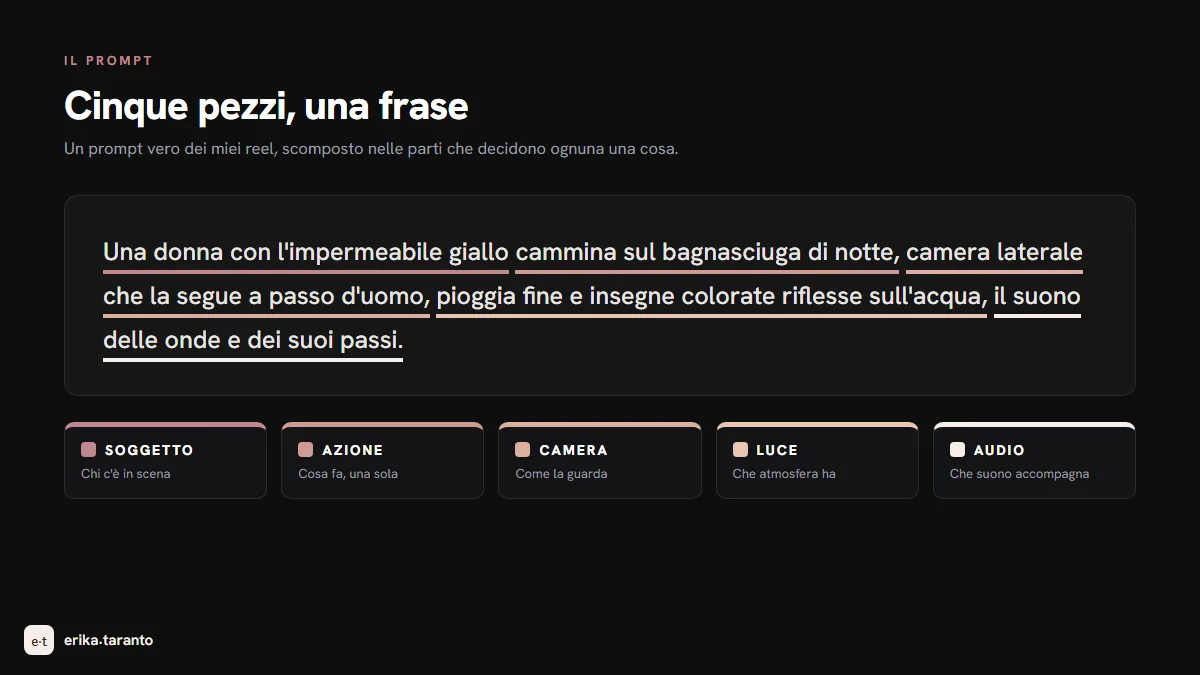
Dopo aver passato un anno a scrivere prompt ogni giorno, ho ridotto tutto a cinque elementi, in questo ordine: soggetto, azione, camera, luce, audio. Uno per volta, nella stessa frase.
Una donna con l'impermeabile giallo cammina sul bagnasciuga di notte, camera laterale che la segue a passo d'uomo, pioggia fine e insegne colorate riflesse sull'acqua, il suono delle onde e dei suoi passi.
Questo è un prompt dei miei reel. Funziona perché ogni parte decide una cosa: chi c'è, cosa fa, come la guarda la camera, che luce ha la scena, che suono accompagna. Quando il modello non deve indovinare nulla, gli errori calano.
E quando nella scena c'è un'emozione, la regola è mostrarla, non etichettarla. "Una donna triste" è un'etichetta: il modello ne fa quello che vuole. "Cammina piano, lo sguardo basso, le spalle chiuse, il passo che si ferma un istante davanti alle vetrine spente" è una scena che si vede, e la tristezza arriva da quello che si vede. Nei miei prompt, quando c'è una persona, descrivo sempre come si muove, dove guarda e che rapporto ha con ciò che la circonda: è questo che fa la differenza.
Le regole che fanno la differenza, imparate a spese mie:
- Un'azione per clip. Due azioni nella stessa clip: la fisica si sgretola in fretta. Due azioni, due clip, si montano insieme.
- Un movimento di camera, o nessuno. "Camera fissa" è un prompt che funziona e che pochi usano: i modelli tendono a vagare, e dichiarare la camera ferma stabilizza tutto. Altrimenti un movimento solo, dichiarato: carrello laterale, push-in lento, orbita.
- Parla in positivo. I modelli non sanno negare: scrivere "senza gente sullo sfondo" è il modo più sicuro per far comparire gente sullo sfondo, perché le parole che il modello raccoglie sono "gente" e "sfondo". Riformula sempre in ciò che vuoi: "una donna che cammina da sola in una città vuota". Stessa scena, raccontata con quello che c'è invece di quello che non c'è.
- Dichiara l'audio quando il motore lo genera. Sui motori che lo generano, come Veo 3, l'audio si chiede nel prompt: il suono delle onde, il traffico lontano, la voce. Se non lo chiedi, deciderà lui, e non sempre come vorresti.
- Usa l'immagine di partenza quando il soggetto deve restare. Il testo descrive, il riferimento garantisce. Per il personaggio ricorrente lo sheet è la soluzione più affidabile.
Oggi i miei prompt li scrive l’AI
Il metodo resta quello. È cambiato chi lo esegue: i prompt finali non li compongo più a mano, li scrive l'AI con cui lavoro.
Le descrivo la scena come la racconterei a voce: "una donna con l'impermeabile giallo che cammina sul bagnasciuga di notte". L'assistente completa il resto, nel mio stile, e il prompt esce come quello dell'esempio di poco fa. E se è una scena con un personaggio che ho già usato, va a riguardarsi le mie scene e la nuova esce coerente con le vecchie.
Non è delegare tutto all'AI: le decisioni restano mie, cosa si vede e che atmosfera deve avere. Il vantaggio è un altro. A una persona, prima o poi, qualcosa scappa: salta la camera, cambia il tono, e la clip di stasera non somiglia più a quella di ieri. All'assistente non scappa niente, perché le regole non le ricorda a memoria: le rilegge, ogni volta.
E funziona perché non è una chat qualunque: è collegata al cervello che tengo sul computer, dove sta scritto come lavoro. Le regole di questa guida ci sono fin dentro, con le correzioni di questi anni: ogni volta che un prompt non mi convinceva, lì finiva una nota, questo no, questo invece sì. Il mio metodo l'ha imparato a furia di critiche. Vale per qualunque assistente: più indicazioni dai, più impara il tuo stile.
E i prompt sono solo l'inizio. La stessa AI si collega a Higgsfield e, col plugin Higgsfield for Blender, entra nella scena: la costruisci in 3D descrivendola, sistemi camera e movimento, e dal video di reference l'assistente scrive il prompt del piano, che il modello genera. Scena, regia, prompt, video: la catena intera si dirige in conversazione. L'ho raccontata per intero in Higgsfield entra in Blender.
Quanto costa creare video con l’AI
La logica dei prezzi è uguale per tutti: gratis per provare, a pagamento per produrre. La tabella qui sotto dice come è fatto ogni piano (aggiornata ad agosto 2026, la riga di Veo ricontrollata il 25 ottobre 2026), non quanto costa. I prezzi, i crediti e le quote cambiano spesso: per quelli di oggi guarda la pagina ufficiale.
| Strumento | Gratis | Per produrre |
|---|---|---|
| Veo 3.1 | nessun gratuito: la generazione video in Gemini richiede un piano Google AI | piani Google AI a pagamento; via API (Google Cloud) si paga a consumo |
| Kling | nessun credito nel piano gratuito | piano Standard a pagamento, poi si sale di piano quando servono più crediti |
| Seedance | prove gratuite via Dreamina (CapCut) | incluso nei piani delle piattaforme che lo ospitano, Higgsfield compresa |
| Higgsfield (piattaforma) | piano gratuito con pochi modelli, senza crediti | piani a crediti mensili; i piani alti includono finestre Unlimited su alcuni modelli, di durata limitata, in cui generi senza contare i crediti |
Cosa riesce e cosa no (i limiti, spiegati onesti)
Qui raccolgo i limiti concreti, quelli che si scoprono dopo settimane di tentativi, con il rimedio per ciascuno.
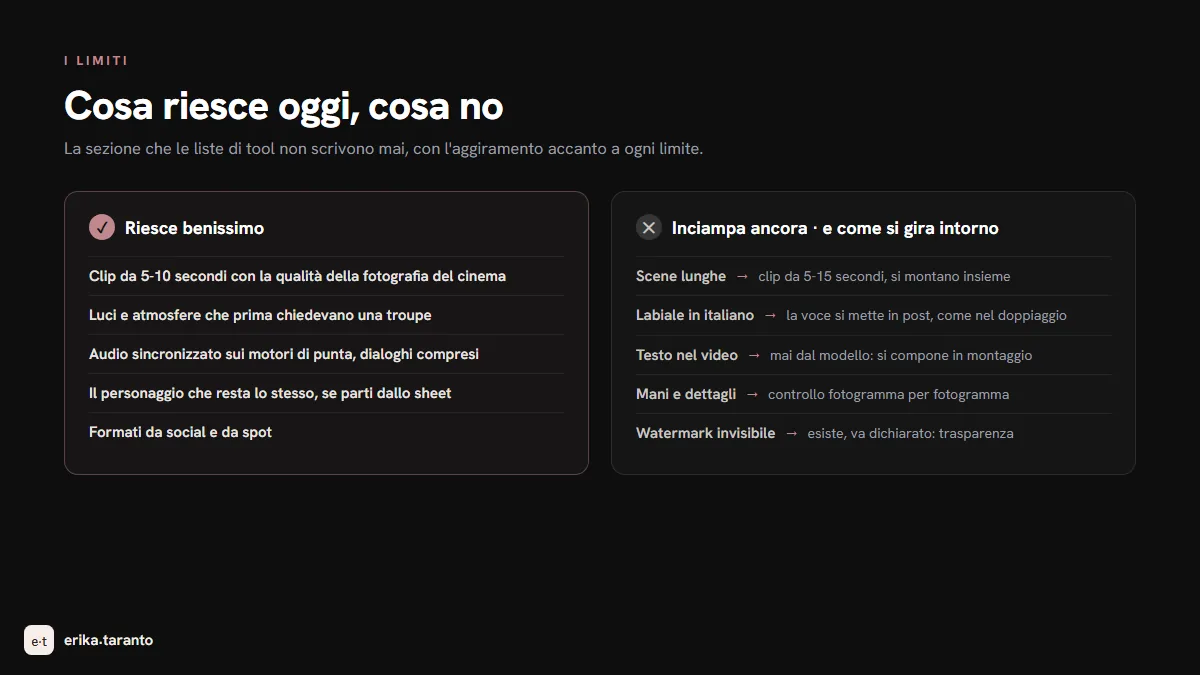
Oggi riesce benissimo: clip di cinque-dieci secondi con la qualità della fotografia del cinema; luci e atmosfere che prima chiedevano una troupe; audio sincronizzato sui motori di punta; il personaggio che resta lo stesso quando usi lo sheet; formati da social e da spot.
Dove ancora fa fatica, e cosa fare:
- Le scene lunghe. Fino a poco tempo fa nessun modello passava i dieci secondi di fila. Seedance 2.5 porta il limite a trenta secondi di fila, e i risultati mi hanno sorpresa; anche Kling 4.0 dichiara clip fino a trenta secondi. Ma anche i trenta secondi migliori restano da tagliare e montare, perché dentro una clip lunga c'è sempre un momento che cade. Nel mio lavoro quotidiano resto sulle clip da cinque secondi; con Seedance arrivo a dieci-quindici, dove qualità e controllo si bilanciano. Il montaggio non è un ripiego: è il modo in cui questi video si fanno.
- Il labiale. I modelli muovono le labbra bene in inglese e in cinese; l'italiano è la lingua dove il distacco si nota di più. Non è un caso: molti di questi modelli nascono in Cina, e tutti si allenano soprattutto in inglese. Quando serve la voce in italiano, genero la scena e metto la voce in post, come si è sempre fatto nel doppiaggio.
- Il testo dentro il video. Mai chiederlo al modello: le scritte escono storte o inventate. I testi si compongono in montaggio, sempre.
- Le mani e i dettagli piccoli. Molto meglio di un anno fa, ma restano il punto da controllare al cento per cento: un anello che cambia mano, una tazza che si riempie da sola. Guarda tutto fotogramma per fotogramma prima di pubblicare.
- Il watermark invisibile. Questo non lo vedi, ma c'è: anche quando un video sembra pulito, molti servizi scrivono dentro il file una firma invisibile che dichiara che è stato generato con l'AI. I social come TikTok hanno strumenti in grado di trovarla. Non è un problema se sei trasparente, e lo devi essere: ma sapere che esiste ti evita sorprese.
Diritti, watermark e uso commerciale
La parte che conta se il video deve uscire dal tuo telefono e finire in un lavoro. La sintesi, che non sostituisce i termini ufficiali né un parere legale.
L'output è tuo e l'uso commerciale è in genere consentito. Sui principali strumenti i termini riconoscono all'utente il materiale generato e ne permettono l'uso commerciale, marketing compreso. Le eccezioni esistono e si legano ai piani gratuiti di qualcuno: verifica sempre il tuo piano, non il tool in generale.
Watermark visibili e invisibili. I piani gratuiti spesso imprimono il watermark visibile, che nei piani a pagamento sparisce. E come abbiamo visto nei limiti, sotto c'è spesso anche la firma invisibile: si chiama provenienza, dichiara l'origine AI del file, non si vede e non si toglie. La trasparenza non è un ostacolo: nell'Unione europea l'articolo 50 del regolamento sull'AI (AI Act) la rende un obbligo dal 2 agosto 2026, sia per la marcatura dei contenuti generati (per i sistemi già sul mercato prima di quella data, la marcatura vale dal 2 dicembre 2026) sia per la dichiarazione dei deepfake, ed è la direzione in cui va tutto il settore.
La responsabilità è tua. Se il modello genera un volto somigliante a una persona reale o un marchio riconoscibile, la responsabilità dell'uso resta a te. E le piattaforme su cui pubblichi, da YouTube in giù, chiedono di dichiarare il contenuto generato o modificato con l'AI: spuntare quella casella non sminuisce il lavoro, protegge te e il pubblico.
Nel mio lavoro per i brand parto sempre da piani e combinazioni con le licenze pulite: quando un cliente firma, la catena dei diritti dev'essere leggibile dall'inizio alla fine.
Caso pratico: da prompt a reel pubblicato
Ti mostro un reel vero, dall'inizio alla fine, così il metodo diventa concreto. Un reel verticale di trenta secondi, di quelli che pubblico io.
- Storia e colori. Decido la storia in tre frasi e scelgo la palette dell'episodio. Ogni episodio della mia serie ha una sua combinazione di colori: è un modo semplice per farsi riconoscere, perché chi segue capisce al volo che quel video è nostro, anche prima di leggere il nome dell'account.
- Lo sheet del personaggio. Genero le immagini del personaggio nei vari punti di vista: da lontano, il viso da vicino, di lato. Servono a mantenere il personaggio uguale in ogni clip del reel: è da lì che ogni generazione parte.
- Le clip. Servono sei-otto clip, ognuna di cinque-otto secondi: una per frase della storia. Le genero una dietro l'altra, dichiarando sempre cosa fa la camera, e rigenero quelle che non reggono.
- Montaggio. Le clip entrano nella timeline e si tagliano sul ritmo: quanto deve durare ogni inquadratura dipende dal video che stai facendo. I sottotitoli si scelgono in base ai colori del video e al gusto: l'unica regola fissa è che siano leggibili su qualsiasi schermo.
- La firma. In fondo al reel metto la end card: due secondi con scritto erikataranto.com. È la firma del video, quello che nel cinema sono i titoli di coda. E sta su ogni versione, verticale per i social e orizzontale per il sito: se un file parte e gira da solo, la firma viaggia con lui.
In tutto: una serata di generazioni e una di montaggio. Trenta secondi finali, otto clip, tutte nate da uno sheet e da cinque elementi nel prompt.
L’AI gira, tu dirigi
Nei miei video l'AI non è l'autore: è la troupe. Sa decidere come si muove l'acqua, come cade la luce, come cammina la gente; quando uno di questi aspetti mi importa, lo decido io e lo scrivo nel prompt, perché quello che non scrivi lo decide lei a modo suo. C'è un limite: più dettagli scrivi, più il risultato assomiglia a quello che hai in testa, ma troppe istruzioni in una clip sola moltiplicano gli errori. La precisione si ottiene dividendo: più clip brevi con poche azioni, invece di una clip lunga con tutto dentro.
Il resto del mestiere è regia, e la regia esiste da quando esiste il cinema: decidere cosa vede il pubblico, per quanto tempo, in che ordine, quando entra il suono e quando il silenzio. L'AI non ha cambiato questo mestiere: ha cambiato quanto costa provarci. Prima servivano una troupe e un budget; adesso bastano un'idea e una serata. Per questo i tutorial "premi il bottone e guarda la magia" deludono: c'è un mestiere da imparare, e si impara facendo. Si può iniziare con una clip sola, stasera stessa, senza spendere nulla.
E se il video ti serve per il tuo brand e preferisci avere chi lo fa tutti i giorni dalla tua parte: è esattamente il mio lavoro, dai reel alle campagne. Scopri come lavoriamo insieme o scrivimi: partiamo da un'idea e la portiamo online.
Le guide dedicate a ogni strumento
Questa guida apre il percorso sui video AI. Ogni strumento ha la sua guida, scritta con lo stesso metodo: uso reale e numeri verificati. Le guide sono tutte online; questa pagina resta il punto da cui ripartire:
- Sora 2: perché ha chiuso, la storia del pioniere dello storyboard;
- Veo 3: la guida, il controllo;
- Kling AI: la guida, il realismo;
- Seedance: la guida, l'interprete;
- Higgsfield: la guida, la piattaforma di regia;
- Higgsfield entra in Blender, quando l'AI costruisce anche la scena 3D;
- Creare video AI gratis, tutte le vie per partire a costo zero.
E se vieni dal mondo delle immagini: la stessa strada l'abbiamo già fatta, parte da creare immagini AI gratis.
Fonti
- OpenAI, la chiusura di Sora (app, sito e API): help.openai.com
- Google Cloud, prezzi della Gemini Enterprise Agent Platform (Veo 3.1): cloud.google.com
- Google DeepMind, Veo: deepmind.google
- Kling AI, piani e crediti: kling.ai
- Higgsfield, piani: higgsfield.ai
- ByteDance Seed, Seedance 2.5: seed.bytedance.com
- Google, generazione video nell'app Gemini (Gemini Omni): gemini.google
- Kling AI, annuncio di Kling 4.0: kling.ai
- Kuaishou, comunicato sul lancio ufficiale di Kling 4.0 (19 ottobre 2026): bernama.com
- Commissione europea, obblighi di trasparenza dell'articolo 50 dell'AI Act: digital-strategy.ec.europa.eu
Per aggiornamenti e novità, c'è il mio canale Telegram
Le ultime news sugli strumenti del video AI le pubblico prima lì.
Lascia un commento
I commenti vengono letti e approvati prima della pubblicazione.