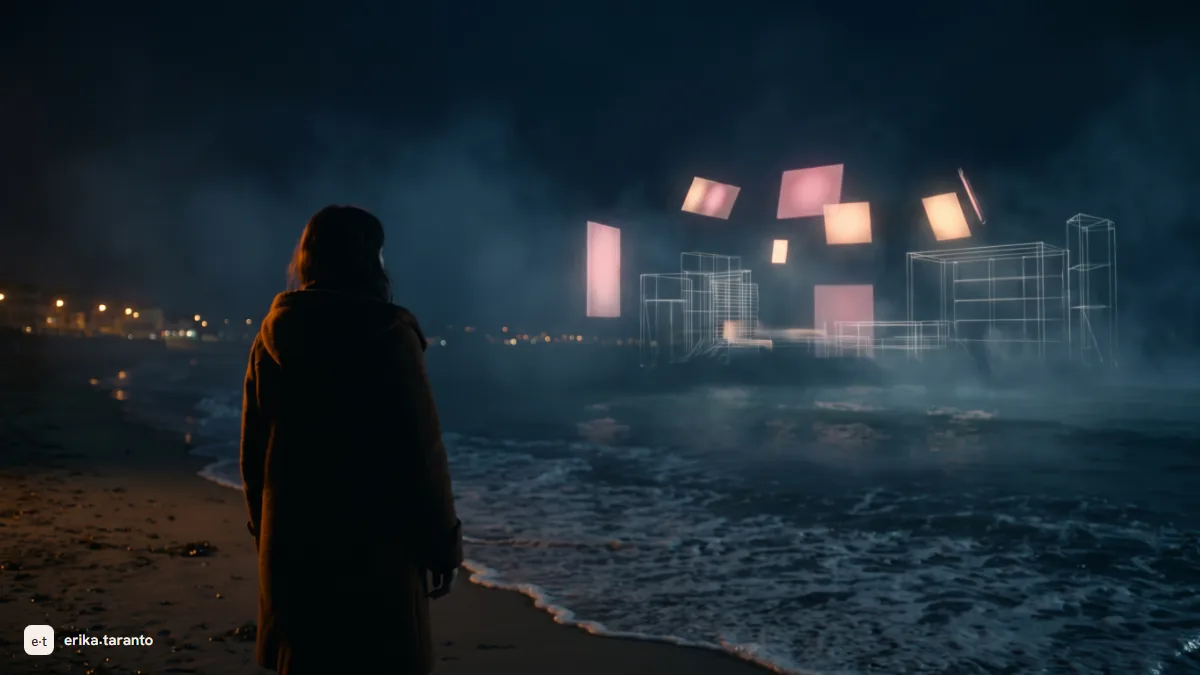
Создание видео с ИИ в 2026 году работает так: вы описываете сцену (или даёте стартовое изображение), и модель генерирует клип длиной в несколько секунд, с камерой, движением и, на ведущих движках, синхронным звуком. Затем клипы отбирают и монтируют, как в кино. Четыре главных инструмента — Veo 3, Kling, Seedance и платформа Higgsfield, которая их размещает и добавляет к ним инструменты режиссуры. Качество уже телевизионное; настоящие ограничения — длина клипов и связность от клипа к клипу. Ниже вы найдёте, как всё это работает, сколько стоит и что с этим можно делать в работе.
Два года назад видео, сгенерированные с ИИ, выглядели как шутка: тела деформировались, как воск, люди шли и растворялись на полпути. Сегодня на тех же инструментах снимают рекламные ролики и короткометражки: мой мини-фильм UNSEEN вошёл в десятку мировых финалистов кинофестиваля AI for Good Film Festival Организации Объединённых Наций и снят именно инструментами из этого руководства. Если хотите увидеть, каких результатов можно достичь, здесь находится полный разбор кейса UNSEEN, с закулисьем.
Меня зовут Erika, и по профессии я генерирую изображения и видео с ИИ для брендов и собственных проектов. Поэтому никакого списка из двадцати инструментов, пересказанного по пресс-релизам: я расскажу про четыре главных, где каждый выигрывает, где у него слабые места, и как собрать видео с нуля по моему рабочему процессу. В конце страницы вы найдёте список отдельных руководств, по одному на инструмент, включая бесплатные пути.
Как работает генерация видео с ИИ сегодня
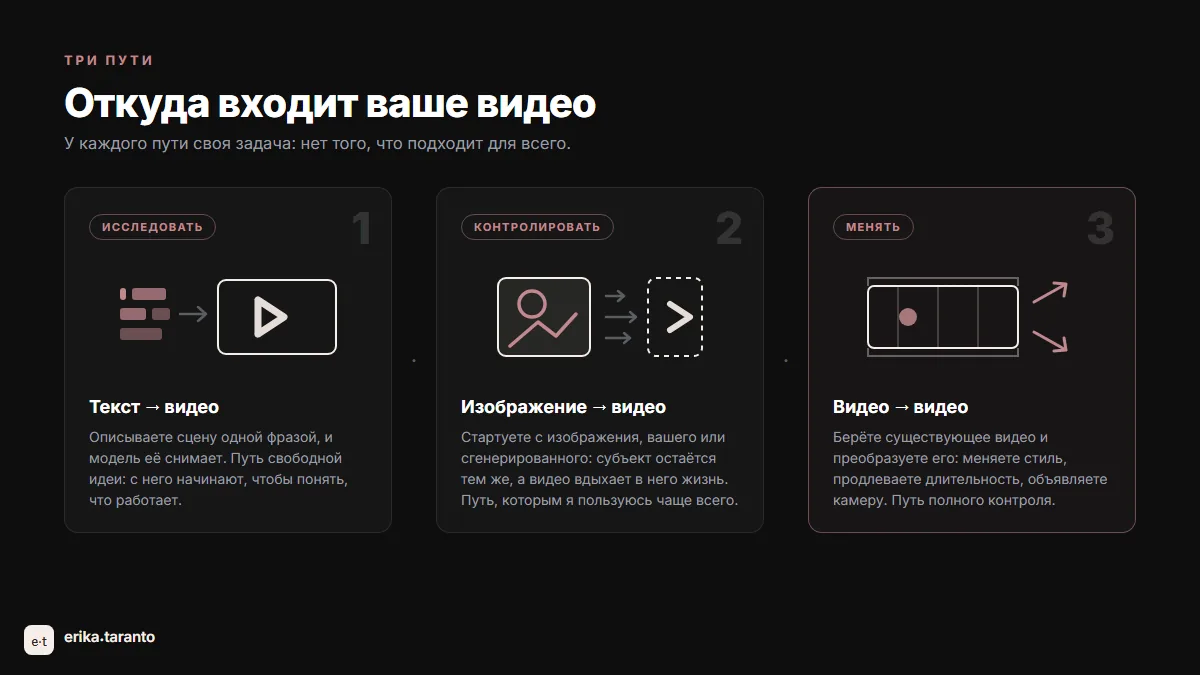
Принцип тот же, что у изображений, с одним дополнительным усложнением: время. Видеомодель должна решить не только, как выглядит каждый кадр, но и что происходит от кадра к кадру. Поэтому входов три.
Из текста в видео (text-to-video). Вы пишете сцену, и модель её снимает: субъект, действие, камера, свет. Это путь, который знают все, и он отлично подходит для исследования идей, потому что каждая фраза может стать кадром.
Из изображения в видео (image-to-video). Вы стартуете с изображения, вашего или сгенерированного с ИИ, и модель его оживляет: она решает движение внутри сцены, сохраняя точку старта. Это самый надёжный путь, когда нужен контроль, потому что субъект уже там, тот же самый, и модель оживляет его, не придумывая заново. Это дорога, которой я пользуюсь больше всего: сначала я генерирую ключевые кадры моделями для изображений, потом оживляю их.
Из видео в видео. Третий путь — изменение видео, которое вы уже сгенерировали, или настоящей съёмки. На сгенерированном материале это наименее хоженая дорога, потому что модели созданы, чтобы создавать, а не перемешивать. Но в обратном направлении, спецэффекты на реальных видео, результаты убедительны: вы берёте настоящую съёмку и добавляете в неё небо, взрывы, существ и магию, сгенерированные с ИИ. Это отдельный метод работы со своими правилами: я расскажу о нём в отдельном посте, когда он выйдет.
И есть факт, который меняет всё по сравнению с прошлым годом: звук. Veo 3 генерирует звук, синхронизированный со сценой, включая диалоги. Ещё недавно видео с ИИ было немым, и голос добавляли потом; сегодня у дождя есть шум, а персонаж может говорить, и губы двигаются в такт словам. Это не деталь: это разница между экспериментом и продуктом.
Четыре главных (и почему)
Вопрос, который приходит мне каждую неделю: «какой лучший?». Это неправильный вопрос: это четыре разных инструмента, и работа становится лучше, когда вы перестаёте искать победителя и начинаете назначать каждую сцену инструменту, который умеет её делать лучше всех. Расскажу о них по одному, как использую их я.
Veo 3 и Veo 3.1 (Google DeepMind) — тот, что следует промпту с самой высокой точностью. Им пользуются во Flow и через API (по данным страницы Gemini, в платном приложении его место занял Gemini Omni, новая видеомодель Google), и текущая версия выполняет запросы так, как вы их написали: вы просите боковой проезд с дождём в контровом свете и получаете ту самую сцену, с камерой и светом, которые вы описали. Нативный звук среди лучших, диалоги держатся. Это движок, который стоит выбирать, когда видео должно точно соответствовать тому, что вы описали. Руководство по Veo 3.
Kling (Kuaishou) — самый реалистичный в передаче движения людей: ходьба, жесты, физика тела. Это один из инструментов, которыми я генерировала сцены UNSEEN, и он остаётся моим ориентиром, когда в кадре кто-то движется. 15 октября 2026 года Kling официально запустил версию 4.0, с клипами до тридцати секунд и стереозвуком. Руководство по Kling AI.
Seedance (ByteDance) лучше всех интерпретирует длинные промпты с несколькими связанными действиями. Когда в сцене три действия подряд, другие модели выполняют два и пропускают одно; Seedance соблюдает все. Версия 2.5, вышедшая 31 июля 2026 года, увеличивает длительность до тридцати секунд за одну генерацию и принимает до пятидесяти референсов за раз (тридцать изображений, десять видео и десять аудио). Если вы пишете сцены, а не отдельные движущиеся картинки, это правильный движок. Руководство по Seedance.
Higgsfield — это другое: не модель, а платформа режиссуры. Внутри вы найдёте несколько движков, включая Seedance и Kling, а поверх движков инструменты, которых не хватает остальным: готовые движения камеры, от проезда до орбиты, продление клипов, консистентность персонажа от генерации к генерации. Это место, где я провожу свои дни, и инструмент, с которым я подаю проекты на конкурсы. Руководство по Higgsfield подробно объясняет платформу, кредиты и тарифы; если хотите попробовать, я захожу каждый день через higgsfield.ai.
А Sora 2? Он закрылся: приложение и сайт отключили 26 апреля 2026 года, а 24 сентября за ними последовал API. Это по-прежнему та модель, которая научила всех работе с проектами, сториборду и камео, и её историю стоит рассказать именно из-за того, как она закончилась: Sora 2 закрыт: альтернативы и чем пользоваться.
Что выбрать для чего
Эта таблица суммирует, когда какой инструмент стоит выбирать. Что доступно бесплатно, обновлено на август 2026 года (строка Veo перепроверена 16 октября 2026 года), и это часто меняется.
| Сильная сторона | Бесплатно, сегодня | Когда выбираю его | |
|---|---|---|---|
| Veo 3 | Контроль, точное следование промптам | бесплатного тарифа нет: генерация видео в Gemini требует тарифа Google AI | Результат верен промпту |
| Kling | Реализм, движение | в бесплатном тарифе кредитов нет | Люди в движении |
| Seedance | Длинные промпты, длительность | бесплатные пробные версии через Dreamina (CapCut) | Сцены с несколькими действиями |
| Higgsfield (платформа) | Режиссура, консистентность, камера | бесплатный тариф с несколькими моделями, без кредитов | Целые проекты, от рила до короткометражки |
Серьёзных способов генерировать видео с ИИ, не платя, мало: таблицы выше достаточно, чтобы понять, сколько можно пробовать, но не для работы. Полный список бесплатных путей, собранный и объяснённый, находится в отдельном руководстве: создание видео с ИИ бесплатно.
На практике инструмент не выбирают: строят комбинацию. Я генерирую ключевые кадры моделями для изображений, оживляю движком, подходящим сцене, и держу проект вместе внутри платформы режиссуры, где консистентность персонажа и камера остаются стабильными от клипа к клипу.
Создать видео с ИИ шаг за шагом
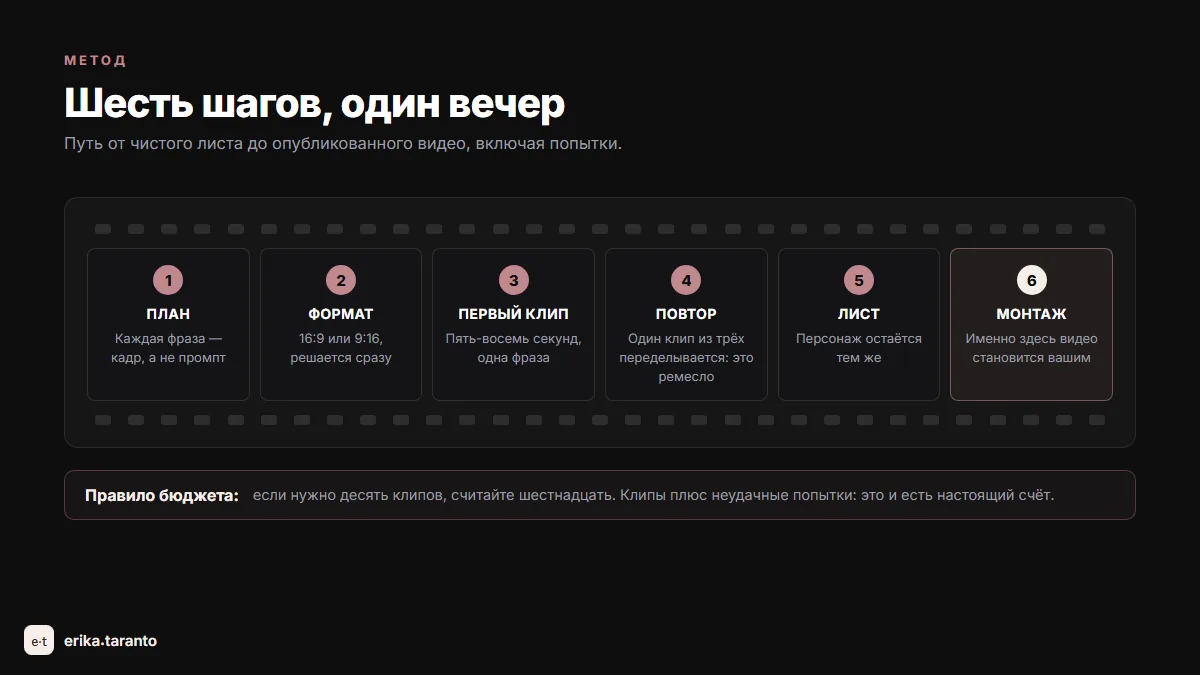
Процесс, которому следую я, от чистого листа до опубликованного видео. Показываю его целиком, включая попытки:
- Пишите план, а не промпт. Прежде чем открывать любой инструмент, я делю видео на фразы: каждая фраза — кадр. «Женщина идёт ночью по кромке воды» — это один клип. «Вывеска бара отражается в луже» — другой. Рил на тридцать секунд — это шесть-восемь фраз.
- Выберите формат сразу. Горизонтальный 16:9 для YouTube и сайта, вертикальный 9:16 для рилов и Stories. Менять его потом — значит перегенерировать всё, потому что кадр с самого начала создаётся в этом формате.
- Сгенерируйте первый клип. Промпт на пять-восемь секунд, один на фразу. Первого дубля почти никогда не хватает.
- Перегенерируйте клипы, которые не держатся. Камера блуждает, физика рушится, деталь меняется: в среднем у меня один клип из трёх переделывается. Это нормальная цена ремесла, а не провал.
- Держите персонажа консистентным. Если в видео есть лицо, которое должно оставаться тем же, метод такой: сначала сгенерировать лист персонажа, серию изображений одного и того же человека с разных ракурсов, издалека, лицо крупно, сбоку, в три четверти. Дальше каждый клип стартует с этих изображений как референсов, и персонаж остаётся узнаваемым от сцены к сцене. Пропуск этого шага — причина номер один, по которой персонаж меняет лицо на середине видео.
- Монтируйте. Клипы попадают на таймлайн, режутся по ритму, добавляется звук. Ни одна модель не даёт вам монтаж: именно здесь видео становится вашим.
- Проверяйте детали вблизи. Руки, тексты, предметы, которые превращаются. Видео с ИИ нужно неспешно пересматривать: приятный сюрприз тоже случается, но публиковать с закрытыми глазами нельзя.
Как написать видеопромпт, который работает
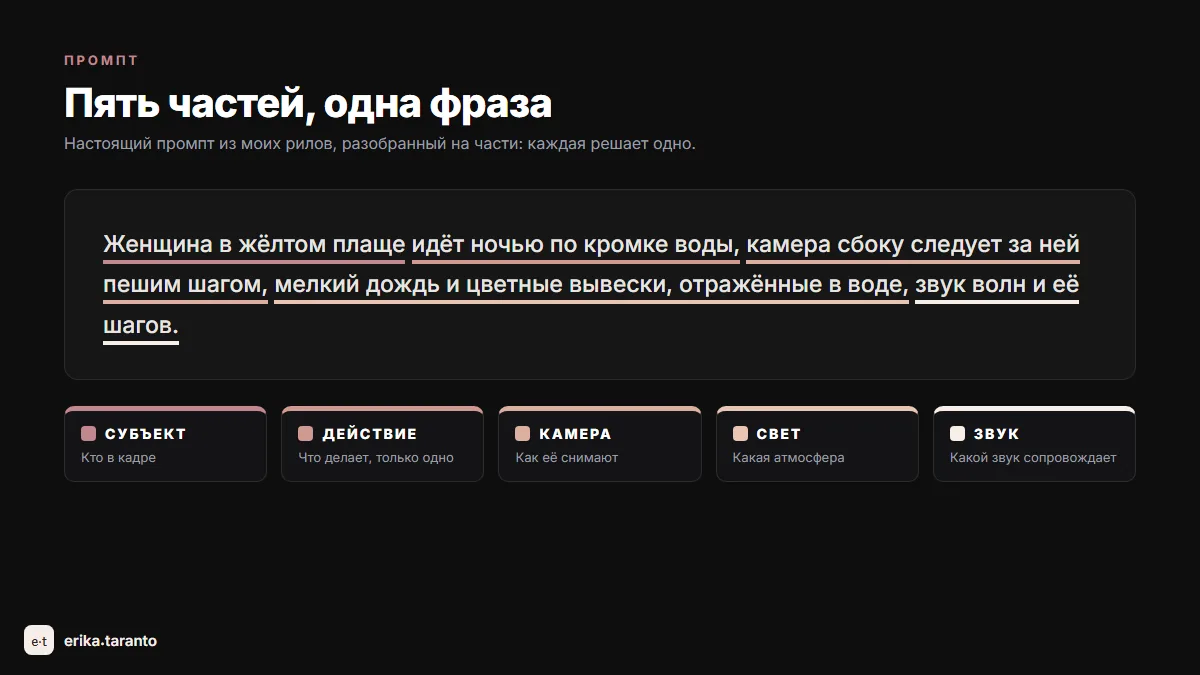
После года, проведённого за написанием промптов каждый день, я свела всё к пяти элементам, в этом порядке: субъект, действие, камера, свет, звук. По одному за раз, в одной фразе.
Женщина в жёлтом плаще идёт ночью по кромке воды, камера сбоку следует за ней в темпе ходьбы, мелкий дождь и цветные вывески, отражённые в воде, звук волн и её шагов.
Это промпт из моих рилов. Он работает, потому что каждая часть решает одно: кто там, что делает, как на неё смотрит камера, какой свет у сцены, какой звук сопровождает. Когда модели не нужно ничего угадывать, ошибок становится меньше.
И когда в сцене есть эмоция, правило — показать её, а не навесить ярлык. «Грустная женщина» — это ярлык: модель делает с ним что хочет. «Идёт медленно, взгляд в пол, плечи опущены, шаг замирает на мгновение перед погасшими витринами» — это сцена, которую видно, и грусть приходит из того, что видно. В моих промптах, когда есть человек, я всегда описываю, как он движется, куда смотрит и в каких отношениях он с тем, что его окружает: именно в этом разница.
Правила, которые решают дело, выученные за мой счёт:
- Одно действие на клип. Два действия в одном клипе — самый быстрый способ увидеть, как физика рассыпается. Два действия, два клипа, монтируются вместе.
- Одно движение камеры или никакого. «Статичная камера» — промпт, который работает и который мало кто использует: модели склонны блуждать, и указание, что камера неподвижна, стабилизирует всё. Иначе одно движение, заданное явно: боковой проезд, медленный наезд, орбита.
- Говорите в позитиве. Модели не понимают отрицания: написать «без людей на фоне» — вернейший способ заставить людей появиться на фоне, потому что слова, которые модель улавливает, это «люди» и «фон». Всегда переформулируйте через то, чего вы хотите: «женщина, идущая одна по пустому городу». Та же сцена, рассказанная через то, что есть, а не через то, чего нет.
- Прописывайте звук, когда движок его генерирует. На движках, которые его генерируют, как Veo 3, звук просят в промпте: шум волн, далёкий трафик, голос. Если не попросите, решит он, и не всегда так, как хотелось бы вам.
- Используйте стартовое изображение, когда субъект должен остаться. Текст описывает, референс гарантирует. Для повторяющегося персонажа лист — самое надёжное решение.
Сегодня мои промпты пишет ИИ
Метод остаётся тем же. Изменился тот, кто его выполняет: финальные промпты я больше не составляю вручную, их пишет ИИ, с которым я работаю.
Я описываю сцену так, как рассказала бы её вслух: «женщина в жёлтом плаще, которая идёт ночью по кромке воды». Ассистент дополняет остальное, в моём стиле, и промпт выходит таким же, как в примере выше. А если это сцена с персонажем, которого я уже использовала, он заново просматривает мои прежние сцены, и новая выходит согласованной со старыми.
Это не значит отдать всё на волю ИИ: решения остаются моими, что попадает в кадр и какая у сцены должна быть атмосфера. Преимущество в другом. Человек рано или поздно что-нибудь упустит: забудет про камеру, сменит тон, и клип сегодняшнего вечера уже не похож на вчерашний. Ассистент не упускает ничего, потому что правила он не помнит наизусть: он перечитывает их каждый раз.
И работает это потому, что это не обычный чат: ассистент подключён к базе знаний, которую я держу на компьютере и где записано, как я работаю. Правила этого руководства лежат там целиком, вместе с поправками всех этих лет: каждый раз, когда промпт меня не убеждал, туда попадала заметка: это нет, это да. Мой метод он выучил на критике. Это верно для любого ассистента: чем больше указаний вы даёте, тем больше он усваивает ваш стиль.
И промпты здесь только начало. Тот же ИИ подключается к Higgsfield и с плагином Higgsfield for Blender входит в сцену: вы строите её в 3D, описывая словами, настраиваете камеру и движение, а из референс-видео ассистент пишет промпт плана, который и генерирует модель. Сцена, режиссура, промпт, видео: вся цепочка режиссируется в разговоре. Целиком я рассказала её в Higgsfield в Blender.
Сколько стоит создавать видео с ИИ
Логика цен одинакова у всех: бесплатно, чтобы попробовать, платно, чтобы производить. Таблица ниже показывает, как устроен каждый тариф (обновлено на август 2026 года, строка Veo перепроверена 25 октября 2026 года), а не сколько он стоит. Цены, кредиты и лимиты часто меняются: актуальные смотрите на официальной странице.
| Инструмент | Бесплатно | Для производства |
|---|---|---|
| Veo 3.1 | бесплатного тарифа нет: генерация видео в Gemini требует тарифа Google AI | платные тарифы Google AI; через API (Google Cloud) платите по факту использования |
| Kling | в бесплатном тарифе кредитов нет | платный тариф Standard, дальше переходите на более высокий, когда нужно больше кредитов |
| Seedance | бесплатные пробы через Dreamina (CapCut) | включён в тарифы платформ, которые его размещают, включая Higgsfield |
| Higgsfield (платформа) | бесплатный тариф с несколькими моделями, без кредитов | тарифы с месячными кредитами; верхние тарифы включают окна Unlimited ограниченной длительности на некоторых моделях, когда вы генерируете, не расходуя кредиты |
Что получается, а что нет (ограничения, честно)
Здесь я собрала настоящие ограничения, те, что выясняются после недель попыток, с решением для каждого.
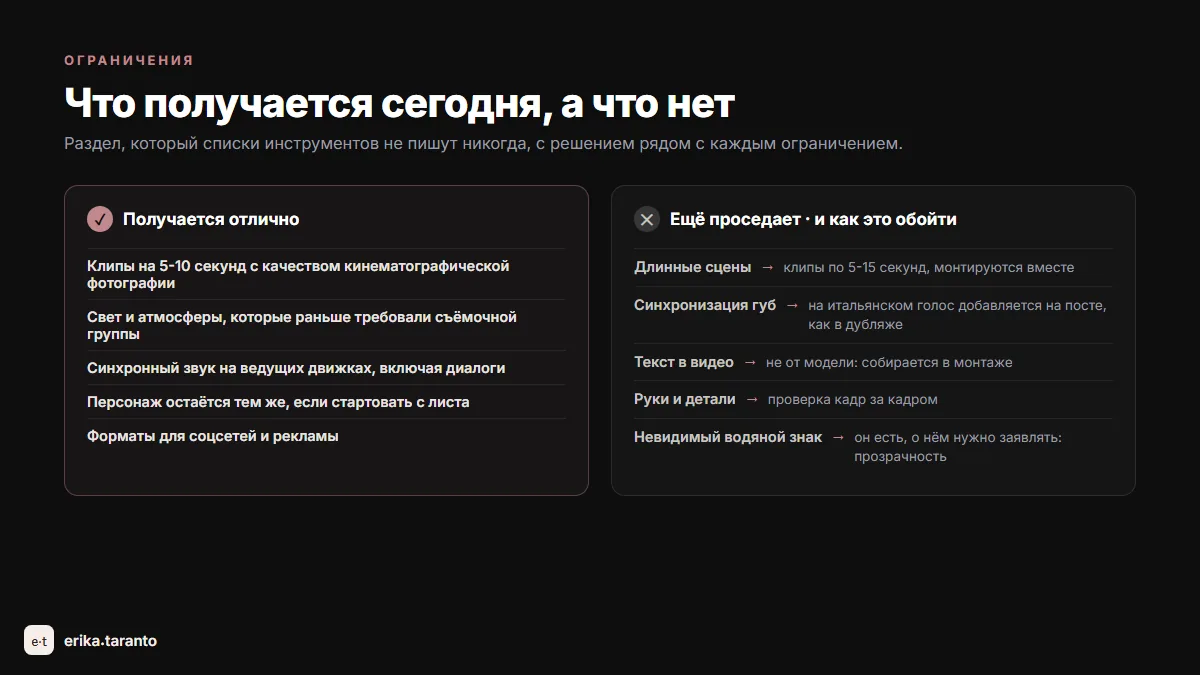
Сегодня отлично получается: клипы на пять-десять секунд с качеством кинематографической фотографии; свет и атмосферы, которые раньше требовали съёмочной группы; синхронизированный звук на ведущих движках; персонаж, который остаётся тем же, когда вы используете лист; форматы для соцсетей и рекламы.
Где видео с ИИ пока проседает и что делать:
- Длинные сцены. До недавнего времени ни одна модель не проходила десять секунд подряд. Seedance 2.5 сдвигает предел до тридцати секунд подряд, и результаты меня удивили; Kling 4.0 тоже заявляет клипы до тридцати секунд. Но даже лучшие тридцать секунд всё равно нужно резать и монтировать, потому что внутри длинного клипа всегда есть момент, который проваливается. В моей ежедневной работе я остаюсь на клипах по пять секунд; с Seedance дохожу до десяти-пятнадцати, где качество и контроль уравновешивают друг друга. Монтаж не костыль: это способ, которым такие видео делаются.
- Синхронизация губ. Модели хорошо двигают губы в английском и китайском; итальянский — язык, где рассинхрон заметнее всего. Это не случайность: многие из этих моделей родом из Китая, и все тренируются в основном на английском. Когда нужен голос на итальянском, я генерирую сцену и добавляю голос на посте, как всегда делали в дубляже.
- Текст внутри видео. Никогда не просите модель об этом: надписи выходят кривыми или выдуманными. Тексты всегда собираются в монтаже.
- Руки и мелкие детали. Гораздо лучше, чем год назад, но остаются пунктом для стопроцентной проверки: кольцо, перескакивающее с одной руки на другую, чашка, наполняющаяся сама. Просмотрите всё кадр за кадром перед публикацией.
- Невидимый водяной знак. Его не видно, но он есть: даже когда видео выглядит чистым, многие сервисы записывают внутрь файла невидимую подпись, сообщающую, что оно сгенерировано с ИИ. У соцсетей вроде TikTok есть инструменты, способные её найти. Это не проблема, если вы прозрачны, а прозрачны вы быть обязаны; но знание, что она существует, избавляет от сюрпризов.
Права, водяные знаки и коммерческое использование
Часть, которая важна, если видео должно выйти из вашего телефона и попасть в рабочий проект. Выжимка, которая не заменяет официальные условия и юридическую консультацию.
Результат ваш, и коммерческое использование в целом разрешено. В основных инструментах условия признают за пользователем права на сгенерированный материал и позволяют его коммерческое использование, включая маркетинг. Исключения существуют и привязаны к бесплатным тарифам некоторых сервисов: всегда проверяйте свой тариф, а не инструмент в целом.
Видимые и невидимые водяные знаки. Бесплатные тарифы часто ставят видимый знак, который на платных исчезает. И, как мы видели в ограничениях, под ним часто лежит и невидимая подпись: она называется provenance («происхождение»), указывает на ИИ-происхождение файла, не видна и не снимается. Прозрачность не препятствие: в Европейском союзе с 2 августа 2026 года статья 50 регламента об ИИ (AI Act) делает её обязательной, и для маркировки сгенерированного контента (для систем, уже находившихся на рынке до этой даты, маркировка обязательна с 2 декабря 2026 года), и для раскрытия информации о дипфейках, и это направление, в котором идёт вся отрасль.
Ответственность ваша. Если модель генерирует лицо, похожее на реального человека, или узнаваемый бренд, ответственность за использование остаётся на вас. И платформы, на которых вы публикуетесь, начиная с YouTube, просят помечать контент, сгенерированный или изменённый с ИИ: поставить эту галочку не принижает работу, она защищает вас и публику.
В моей работе для брендов я всегда стартую с тарифов и комбинаций с чистыми лицензиями: когда клиент подписывает, цепочка прав должна быть читаемой от начала до конца.
Практический случай: от промпта до опубликованного рила
Покажу настоящий рил, от начала до конца, чтобы метод стал наглядным. Вертикальный рил на тридцать секунд, из тех, что публикую я.
- История и цвета. Я выстраиваю историю в трёх фразах и выбираю палитру эпизода. У каждого эпизода моей серии своя цветовая комбинация: это простой способ стать узнаваемым, потому что подписчик сразу понимает, что это видео наше, ещё до того, как прочтёт имя аккаунта.
- Лист персонажа. Я генерирую изображения персонажа с разных ракурсов: издалека, лицо крупно, сбоку. Они нужны, чтобы персонаж был одинаковым в каждом клипе рила: от них стартует каждая генерация.
- Клипы. Нужно шесть-восемь клипов, каждый по пять-восемь секунд: по одному на фразу истории. Я генерирую их одну за другой, всегда указывая, что делает камера, и перегенерирую те, что не держатся.
- Монтаж. Клипы попадают на таймлайн и режутся по ритму: сколько должен длиться каждый кадр, зависит от видео, которое вы делаете. Субтитры выбираются под цвета видео и вкус: единственное фиксированное правило — они должны читаться на любом экране.
- Подпись. В конце рила я ставлю финальную карточку: две секунды с надписью erikataranto.com. Это подпись видео, то, чем в кино являются титры. И она стоит на каждой версии, вертикальной для соцсетей и горизонтальной для сайта: если файл уходит и живёт сам, подпись путешествует с ним.
Итого: один вечер генераций и один монтажа. Тридцать финальных секунд, восемь клипов, все рождённые из одного листа персонажа и пяти элементов в промпте.
ИИ снимает, вы режиссируете
В моих видео ИИ не автор: он съёмочная группа. Он умеет решать, как движется вода, как падает свет, как идут люди; когда один из этих аспектов мне важен, решаю я и пишу это в промпте, потому что то, чего вы не написали, он решает по-своему. Есть ограничение: чем больше деталей вы пишете, тем ближе результат к тому, что у вас в голове, но слишком много инструкций в одном клипе умножает ошибки. Точность достигается дроблением: больше коротких клипов с малым числом действий вместо одного длинного со всем сразу.
Остальное в этом ремесле — режиссура, и она существует с тех пор, как существует кино: решать, что видит публика, как долго, в каком порядке, когда входит звук и когда тишина. ИИ не изменил это ремесло: он изменил, сколько стоит попробовать. Раньше нужны были группа и бюджет; теперь достаточно идеи и вечера. Поэтому туториалы в стиле «нажми кнопку и смотри на магию» разочаровывают: есть ремесло, которое нужно освоить, и оно осваивается делом. Начать можно с одного клипа, сегодня вечером, не потратив ничего.
А если видео нужно для вашего бренда и вы предпочитаете иметь на своей стороне того, кто делает это каждый день: это ровно моя работа, от рилов до кампаний. Посмотрите, как мы работаем вместе или напишите мне: начнём с идеи и выведем её в онлайн.
Руководства по каждому инструменту
Это руководство открывает маршрут по видео с ИИ. У каждого инструмента есть своё руководство, написанное тем же методом: реальное использование и проверенные цифры. Все руководства уже опубликованы; эта страница остаётся точкой, с которой можно начать заново:
- Sora 2: почему закрылся, история пионера сториборда;
- Veo 3: руководство, контроль;
- Kling AI: руководство, реализм;
- Seedance: руководство, исполнитель;
- Higgsfield: руководство, платформа режиссуры;
- Higgsfield в Blender, когда ИИ строит и 3D-сцену;
- Создание видео с ИИ бесплатно, все пути старта без затрат.
А если вы пришли из мира изображений: ту же дорогу мы уже прошли, она начинается с создания изображений с ИИ бесплатно.
Источники
- OpenAI, закрытие Sora (приложение, сайт и API): help.openai.com
- Google Cloud, цены Gemini Enterprise Agent Platform (Veo 3.1): cloud.google.com
- Google DeepMind, Veo: deepmind.google
- Kling AI, тарифы и кредиты: kling.ai
- Higgsfield, тарифы: higgsfield.ai
- ByteDance Seed, Seedance 2.5: seed.bytedance.com
- Google, генерация видео в приложении Gemini (Gemini Omni): gemini.google
- Kling AI, анонс Kling 4.0: kling.ai
- Kuaishou, пресс-релиз об официальном запуске Kling 4.0 (19 октября 2026 года): bernama.com
- Европейская комиссия, обязательства по прозрачности по статье 50 регламента об ИИ: digital-strategy.ec.europa.eu
Обновления и новости — в моём Telegram-канале
Последние новости об инструментах видео с ИИ я публикую сначала там.
Оставить комментарий
Комментарии проходят проверку перед публикацией.