2026 年用 AI 做视频是这样运作的:你描述场景(或给它一张起始图),模型生成一条几秒的 clip,带运镜、动作,旗舰引擎还带同步音频。然后 clip 要挑选、要剪辑,和电影一样。四个主要工具是 Veo 3、Kling、Seedance 和托管它们、再往上加导演工具的平台 Higgsfield。质量已经是电视级;真正的限制是 clip 时长和 clip 之间的一致性。下面讲清楚它怎么运作、要花多少钱,以及你能用它做哪些工作。
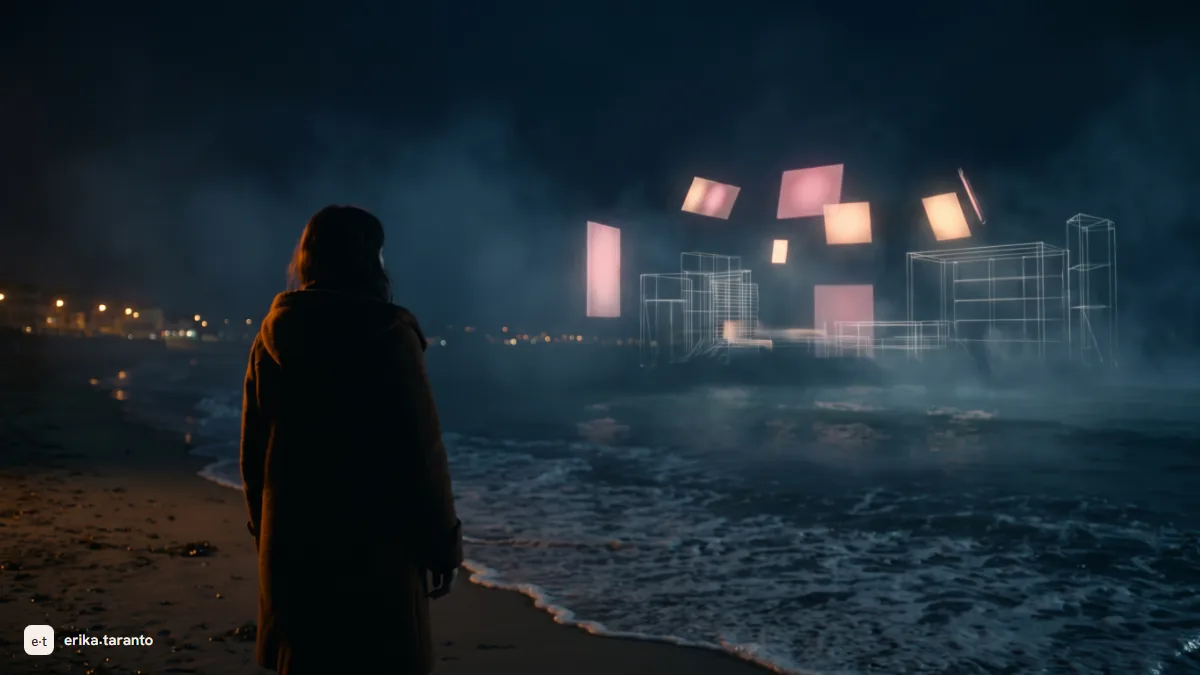
两年前 AI 生成的视频像玩笑:身体像蜡一样变形,人走到一半融化掉。今天用同样的工具能做出广告和短片:我的短片 UNSEEN 进了联合国 AI for Good Film Festival 全球 10 强决赛,而且正是用这篇指南里的工具拍的。想看能达到什么样的结果,这里有 UNSEEN 的完整案例研究,里面还有幕后花絮。
我叫 Erika,我的本行就是为品牌和自己的项目用 AI 生成图像和视频。所以没有那种读新闻稿拼出来的二十个工具清单:我给你讲四个主要的,各自在哪赢、在哪吃力,以及怎么按我自己的流程从零做出一条视频。提到的每个工具都有专门的指南,页面最后有完整清单,免费路线也包括在内。
今天的 AI 视频生成怎么运作
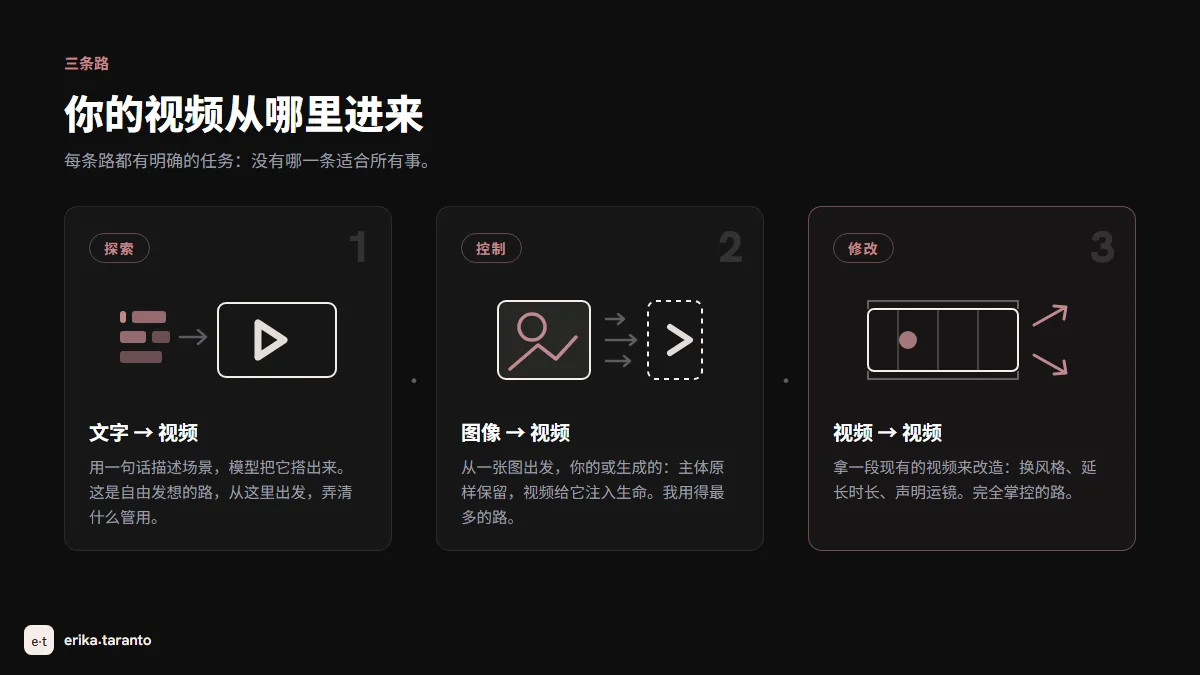
原理和图像一样,只是多了一层复杂度:时间。视频模型不仅要决定每一帧长什么样,还要决定帧与帧之间发生什么。所以入口有三条。
从文字到视频(text-to-video)。你写下场景,模型把它拍出来:主体、动作、运镜、光。这是所有人都认识的路,也非常适合探索想法,因为每句话都能变成一个镜头。
从图到视频(image-to-video)。从一张图出发,你的或 AI 生成的,模型让它动起来:在保住起点的前提下决定场景里的运动。需要控制时这是最可靠的路,因为主体已经原样在那里,模型直接让它动起来,不必重新创造。这是我用得最多的路:先用图像模型生成关键帧,再把它们动画化。
从视频到视频。第三条路是修改一段你已经生成的视频,或一段实拍。对生成的素材它是走得最少的路,因为这些模型生来是为了创造,不是为了改来改去。但在相反方向,对真实视频做特效,结果很有说服力:从真实素材出发,往里面加 AI 生成的天空、爆炸、生物和魔法。这是一门独立的手艺,有自己的规则:等专门的帖子出来我再讲。
然后是相比去年改变一切的那一点:音频。Veo 3 生成与场景同步的音频,对白包括在内。不久前 AI 视频还是哑的,声音后期加;今天雨有雨声,人物说话嘴唇跟着字走。这不是细节:这是一个实验和一件产品之间的差别。
四个主要的(以及为什么)
每周都找上我的问题是「哪个最好?」。这个问题问错了:它们是四个不同的工具,而当你不再找赢家、开始把每个场景分给最会做它的工具时,工作就变好了。我一个一个讲,按我自己用的方式。
Veo 3 和 Veo 3.1(Google DeepMind)是跟随提示词最精确的。它用在 Flow 和 API 里(据 Gemini 页面,在付费应用里,它的位置已由 Google 的新视频模型 Gemini Omni 接替),当前版本照你写的执行:你要一条逆光下雨中的侧向轨道镜头,得到的就是那个场景,运镜和光都照你描述的。原生音频在最好的之列,对白撑得住。这是视频必须和你描述的完全一致时该选的引擎。Veo 3 指南。
Kling(快手)在人物动作上最真实:走路、手势、身体的物理。它是我用来生成 UNSEEN 场景的工具之一,画面里有人动时它仍是我的首选。2026 年 10 月 15 日,Kling 正式发布了 4.0 版,clip 最长三十秒,带立体声音频。Kling AI 指南。
Seedance(ByteDance)是四个里跟随长提示词、多个连贯动作最准的。场景有三件事要按顺序发生时,别的模型做两件、丢一件;Seedance 全都照做。2026 年 7 月 31 日推出的 2.5 版把时长拉到一次生成三十秒,一次最多接受五十个参考(三十张图、十段视频和十段音频)。如果你写的是戏,不是一张张会动的图,它就是对的引擎。Seedance 指南。
Higgsfield 是另一样东西:不是模型而是导演平台。里面有多个引擎,Seedance 和 Kling 都在,引擎之上是别人没有的工具:现成的运镜,从轨道到环绕,clip 延长,一次生成到下一次的人物一致性。我每天就泡在这里,也是我用来送项目参赛的工具。Higgsfield 指南把平台、积分和计划讲得很细;想试的话,我每天从 higgsfield.ai 进。
那 Sora 2 呢?它关闭了:应用和网站于 2026 年 4 月 26 日下线,9 月 24 日 API 也跟着走到同一终点。它仍然是教会所有人按项目工作、storyboard 和 cameo 的那个模型,它的故事值得讲一讲,尤其是它的结局:Sora 2 已关闭:替代方案与今天用什么。
哪个用在哪
这张表总结什么时候选哪个。哪些东西免费,更新到 2026 年 8 月(Veo 一行在 2026 年 10 月 16 日重新核对过),经常变。
| 强项 | 今天的免费额度 | 什么时候选它 | |
|---|---|---|---|
| Veo 3 | 可控,严格跟随提示词 | 没有免费计划:在 Gemini 里生成视频需要 Google AI 计划 | 结果忠于提示词 |
| Kling | 写实,运动 | 免费计划不含积分 | 运动中的人 |
| Seedance | 长提示词,时长 | Dreamina(CapCut)上的免费试用 | 多动作场景 |
| Higgsfield(平台) | 导演、一致性、运镜 | 免费计划,模型很少,不含积分 | 整个项目,从 reel 到短片 |
不花钱又能正经生成 AI 视频的途径很少:上面的表格够弄清能试到什么程度,不够用来干活。免费路径的完整清单,汇总并讲解过,在专门的指南里:免费 AI 视频生成。
实际操作中不是只选一个工具,而是搭配出一个组合。我用图像模型生成关键帧,用适合场景的引擎动画化,再把项目整个装进一个导演平台里,在那里人物一致性和运镜在各条 clip 之间保持稳定。
用 AI 做一条视频,一步一步
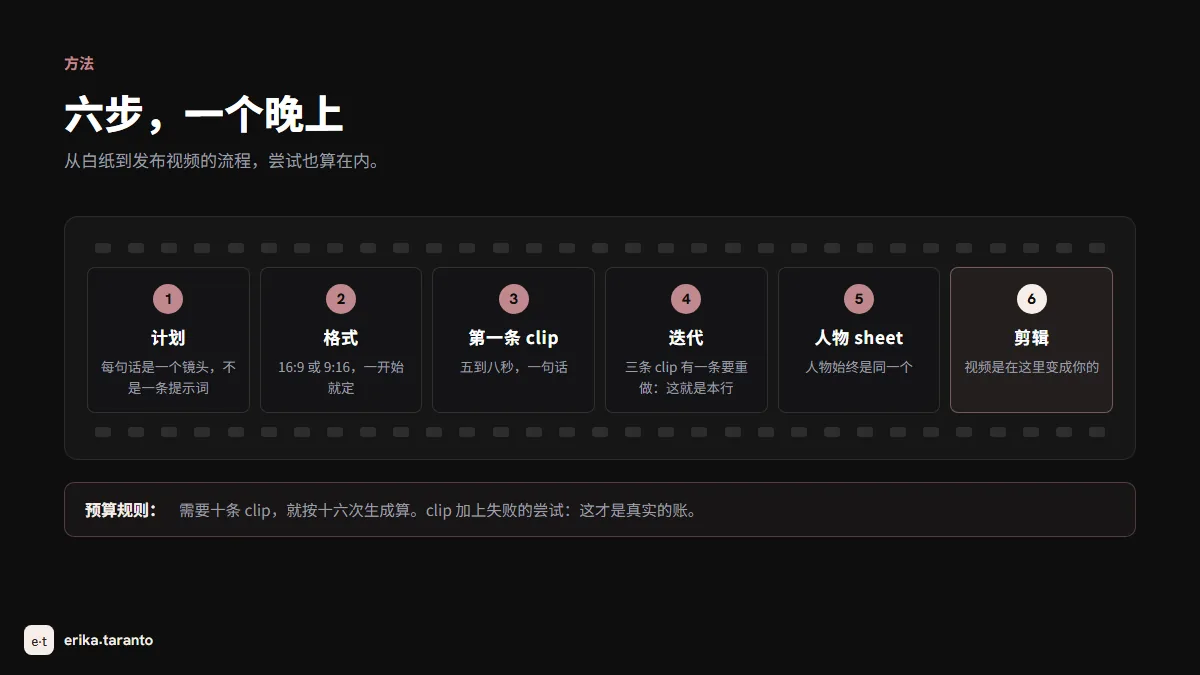
我自己的流程,从白纸到发布的视频。完整给你看,试错也包括在内:
- 写计划,不是写提示词。碰任何工具之前,我把视频拆成句子:一句话一个镜头。「一个女人夜里走在沙滩与水的交界处」是一条 clip。「咖啡馆的招牌映在水洼里」是另一条。三十秒的 reel 是六到八句话。
- 立刻选格式。横屏 16:9 给 YouTube 和网站,竖屏 9:16 给 reel 和 Stories。之后改格式等于全部重新生成,因为镜头从一开始就是按这个格式生成的。
- 生成第一条 clip。每个提示词对应五到八秒,一句话一条。第一枪几乎从不够用。
- 把撑不住的 clip 重新生成。运镜漂、物理塌、细节变。平均下来,我的三条 clip 里有一条要重做。这是这个行当的正常成本,不是失败。
- 保持人物一致。如果视频里有一张必须不变的脸,方法是先生成人物 sheet:同一个人的系列图,多个视角,远景、脸部近景、侧面、四分之三侧。此后每条 clip 都以这些图为参考出发,人物在场景之间保持可辨认。跳过这一步是人物拍到一半换脸的第一号原因。
- 剪。clip 上时间线,按节奏切,加音频。没有哪个模型会替你剪辑:视频是在这里变成你的。
- 凑近检查细节。手、文字、会变形的物体。AI 视频要慢慢过一遍:惊喜也有,但不能闭着眼发布。
怎么写一条管用的视频提示词
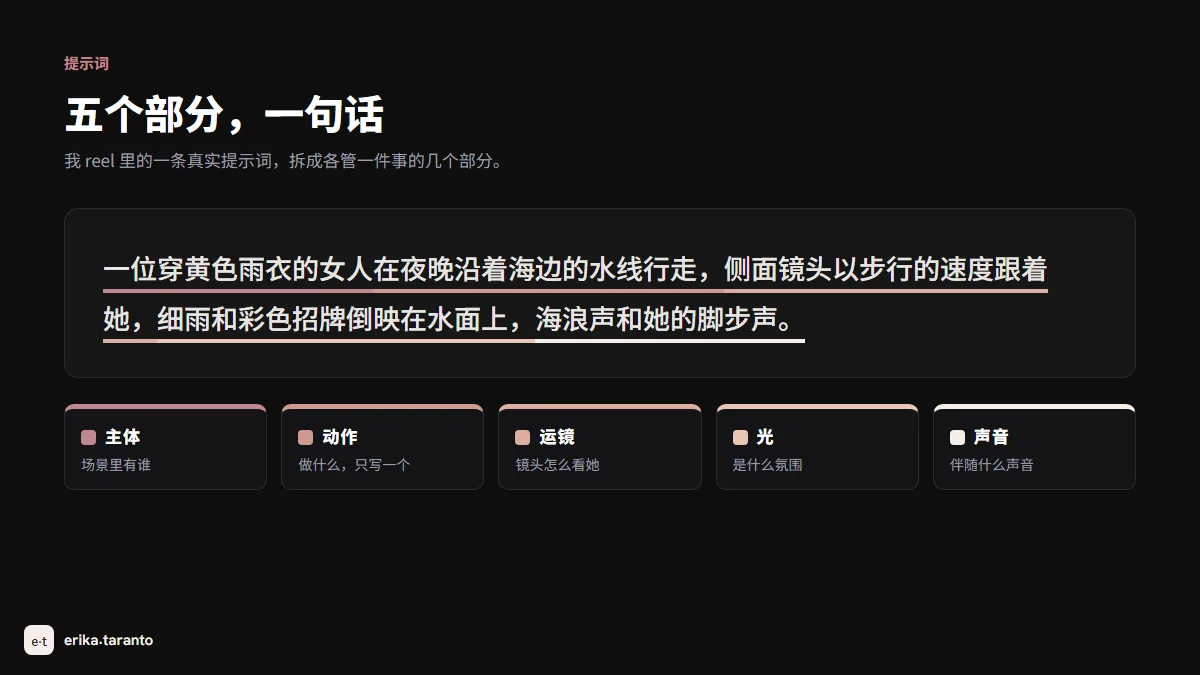
每天写提示词写了一年之后,我把一切缩到五个要素,按这个顺序:主体、动作、运镜、光、声音。一个一个来,在同一句话里。
一位穿黄色雨衣的女人在夜晚沿着海边的水线行走,侧面镜头以步行的速度跟着她,细雨和彩色招牌倒映在水面上,海浪声和她的脚步声。
这是我 reel 的一条提示词。它管用,是因为每个部分决定一件事:有谁、做什么、运镜怎么看她、场景什么光、什么声音伴随。模型不用猜任何东西,错误就少。
而当场景里有情绪,规则是演出来,不是贴标签。「一个忧伤的女人」是标签:模型拿它想干什么就干什么。「她慢慢走,目光向下,肩膀收着,在熄灯的橱窗前停了一瞬」是一场看得见的戏,忧伤从看得见的东西里自己来。在我的提示词里,只要有人物,我永远写她怎么动、看向哪里、和周围是什么关系:差别就在这三件事上。
真正造成差别的规则,都是我交过学费才学到的:
- 一条 clip 一个动作。同一条 clip 里两个动作是看物理崩塌最快的方式。两个动作,两条 clip,剪在一起。
- 一个运镜,或者没有。「固定镜头」是一条有效却少有人用的提示词:模型爱漂,声明镜头不动能稳住一切。否则就一个运动,声明出来:侧向轨道、缓慢推近、环绕。
- 用肯定的说法。模型不会否定:写「背景里没有人」是让背景里冒出人来的最稳方式,因为模型抓到的词是「人」和「背景」。永远改写成你要的:「一个女人独自走在空荡荡的城市里」。同一个场景,用有什么来讲,不用没什么来讲。
- 引擎生成音频时声明它。在生成音频的引擎上,比如 Veo 3,音频要在提示词里提出来:海浪的声音、远处的车流、人声。如果你不提,它就自己决定,而且不总是按你想要的。
- 主体必须留得住时用起始图。文字负责描述,参考负责保证。对固定人物,sheet 是最可靠的解。
我的提示词,现在是 AI 写的
方法还是那个方法。变的是谁来执行:最终的提示词我不再自己一句一句拼,写它的是和我一起工作的那个 AI。
我像口头讲一遍那样向它描述场景:「一位穿黄色雨衣的女人夜里沿着海边的水线行走」。助手按我的风格补全其余部分,出来的提示词就和我前面那个例子一样。而如果场景里是一个我已经用过的人物,它会回去重看我之前的场景,新的和旧的保持一致。
这不是把一切交给 AI:决定还是我的,画面里看得见什么、要什么气氛。好处在别处。人总有失手的时候:忘了运镜,换了调子,今晚的 clip 就不再像昨晚的。助手什么都漏不掉,因为那些规则它不是靠记的:它每次都重新读一遍。
它能行,是因为它不是随便一个聊天助手:它连着我在电脑里存着的那个大脑,那里写着我怎么工作。这份指南的规则也全在里头,带着这几年的修正:每次有哪个提示词让我不满意,那里就多一条笔记,这个不行,这个可以。我的方法,它是靠一条条批评学来的。这对哪个助手都成立:你给的指示越多,它对你的风格学得越透。
而提示词只是开始。同一个 AI 连着 Higgsfield,再通过 Higgsfield for Blender 插件走进场景:你用描述把场景在 3D 里搭出来,把镜头和运动安排好,助手再从参考视频写出这个镜头的提示词,交给模型生成。场景、导演、提示词、视频:整条链路都在对话里指挥。我在 Higgsfield 进入 Blender 里把它完整讲了一遍。
用 AI 做视频多少钱
价格逻辑人人一样:免费试用,付费生产。下面的表格讲的是每个计划怎么构成(更新到 2026 年 8 月,Veo 一行在 2026 年 10 月 25 日重新核对过),不是它要花多少钱。价格、积分和额度经常变动:以官方页面当前显示的为准。
| 工具 | 免费 | 生产 |
|---|---|---|
| Veo 3.1 | 没有免费计划:在 Gemini 里生成视频需要 Google AI 计划 | 付费的 Google AI 计划;走 API(Google Cloud)按用量付费 |
| Kling | 免费计划不含积分 | 付费的 Standard 计划,需要更多积分时再升级 |
| Seedance | Dreamina(CapCut)免费试用 | 包含在托管它的平台计划里,Higgsfield 也在内 |
| Higgsfield(平台) | 免费计划,模型很少,不含积分 | 月度积分计划;高档位在部分模型上包含 Unlimited 窗口,时长有限,窗口内生成不用数积分 |
什么能做、什么不能(局限,诚实讲)
这里收的是真实的局限,试上几周才会发现的那种,每个旁边有对策。
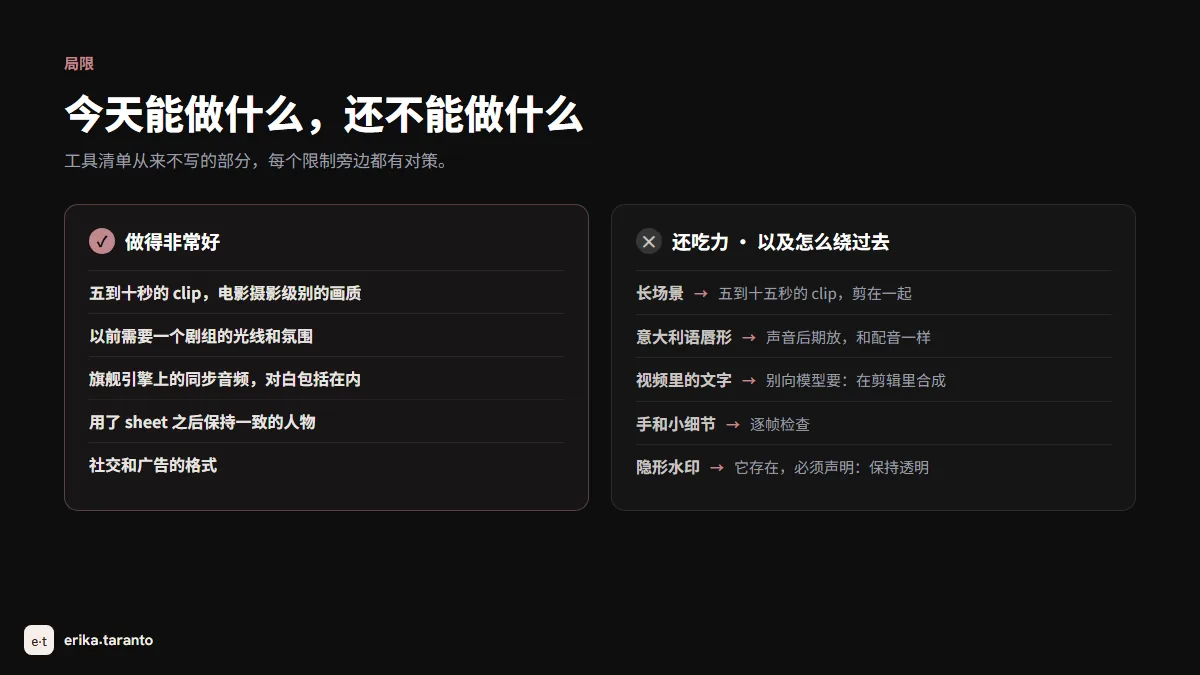
今天做得非常好的:五到十秒的 clip,画质是电影摄影级别;以前要靠剧组才能做出的光线和氛围;旗舰引擎上的同步音频;用了 sheet 之后保持一致的人物;社交和广告的格式。
还吃力的地方,以及怎么办:
- 长场景。不久前还没有模型能连续超过十秒。Seedance 2.5 把上限推到连续三十秒,结果让我惊喜;Kling 4.0 也标明 clip 最长三十秒。但即使最好的三十秒也还要剪要接,因为长 clip 里总有一刻会垮。日常工作中我留在五秒的 clip 上;用 Seedance 我会做到十到十五秒,在那里质量和控制互相平衡。剪辑不是退而求其次:这些视频就是这么做出来的。
- 口型同步。模型在英文和中文里口型对得好;意大利语是差距最明显的语言。这不是巧合:这些模型很多诞生在中国,而且都主要用英文训练。需要意大利语人声时,我生成画面,声音后期放,和配音行业从来做的一样。
- 视频里的文字。永远别向模型要:字出来是歪的或编的。文字永远在剪辑里合成。
- 手和小细节。比一年前好得多,但仍是百分之百要检查的点:一枚换手的戒指,一只自己续满的杯子。发布前逐帧看。
- 隐形水印。这个你看不见,但它在:即使一段视频显得干净,很多服务也在文件里写了一道隐形签名,声明它是 AI 生成的。TikTok 这类社交平台有能找到它的工具。如果你透明,这不是问题,而且你必须透明:但知道它存在能省掉意外。
版权、水印和商业使用
视频要走出手机、用到工作里时,这一节最要紧。摘要,不替代官方条款,也不替代法律意见。
产出是你的,商业使用总体允许。主要工具的条款承认用户对生成内容的权利,允许商业使用,营销包括在内。例外存在,而且和某些免费计划绑定:永远核对你的计划,不是工具整体。
可见和不可见的水印。免费计划常打可见水印,付费计划里它消失。而正如局限里看到的,下面往往还有隐形签名:它叫来源(provenance),声明文件的 AI 来源,看不见也去不掉。透明不是障碍:在欧盟,自 2026 年 8 月 2 日起,《人工智能法》(AI Act)第 50 条把它变成义务,既针对生成内容的标记(对此日期前已投放市场的系统,标记义务自 2026 年 12 月 2 日起适用),也针对深度伪造的声明,而这也是整个行业的方向。
责任在你。如果模型生成了像真人的脸或可辨认的品牌,使用的责任在你。而你发布的平台,从 YouTube 往下,都要求声明 AI 生成或修改的内容:勾上那个框不会贬低作品,而是保护你和观众。
我给品牌做项目时永远从许可干净的计划和组合出发:客户签字时,权利链条必须从头到尾可读。
实战案例:从提示词到发布的 reel
给你看一条真实的 reel,从头到尾,让方法落到实处。一条三十秒的竖屏 reel,我自己发的那种。
- 故事和颜色。我用三句话定故事,选这一集的色板。我系列的每一集有自己的颜色组合:这是让人认出你的简单办法,关注的人在看到账号名字之前就明白那条视频是我们的。
- 人物 sheet。我生成人物各视角的图:远景、脸部近景、侧面。它们用来让人物在 reel 的每条 clip 里保持一样:每次生成都从这里出发。
- clip。需要六到八条,每条五到八秒:故事一句话一条。一条接一条生成,永远声明运镜在做什么,撑不住的重生成。
- 剪辑。clip 上时间线,按节奏切:每个镜头留多久取决于你在做哪条视频。字幕根据视频的颜色和个人口味来选:唯一的固定规则是在任何屏幕上都可读。
- 签名。reel 最后我放 end card:两秒,写着 erikataranto.com。这是视频的签名,对应电影里的片尾字幕。每个版本上都有,社交平台用竖版,网站用横版:如果文件自己流传出去,签名也跟着它走。
总计:一晚生成,一晚剪辑。最终三十秒,八条 clip,全都出自一张 sheet 和提示词里的五个要素。
AI 来拍,你来导
在我的视频里 AI 不是作者:它是剧组。它决定水怎么动、光怎么落、人怎么走。其中哪样对我要紧,就由我来定,写进提示词:因为你没写的,它会按自己的方式决定。这里也有限度:细节写得越多,结果越接近你脑子里的样子,但一条 clip 里塞太多指令就会出错。精确靠拆分:更多短 clip,每条更少的动作,而不是一条长 clip 装下一切。
这行的其余部分是导演活,而导演活从有电影那天就存在:决定观众看什么、看多久、什么顺序、声音什么时候进、沉默什么时候来。AI 没有改变这门手艺:它改变的是试一次的成本。从前要一个组和一笔预算;现在一个想法加一个晚上就够。「按下按钮看魔法」式的教程让人失望,原因就在这里:有一门手艺要学,而且要边做边学。今晚就可以从一条 clip 开始,免费。
如果这条视频是给你的品牌用的,而且你更希望有天天做这件事的人站在你这边:这恰好就是我的工作,从 reel 到广告活动。看看我们怎么合作,或者写信给我:从一个想法开始,把它带到线上。
每个工具的专门指南
这篇指南是 AI 视频这条路的起点。每个工具都有专门的指南,用同一个方法写:真实使用加核实的数字。这些指南都已上线,而这一页永远是你重新出发的起点:
- Sora 2:为什么关闭了,storyboard 先驱的故事;
- Veo 3:指南,控制;
- Kling AI:指南,写实;
- Seedance:指南,诠释者;
- Higgsfield:指南,导演平台;
- Higgsfield 进入 Blender,当 AI 也来搭建 3D 场景;
- 免费 AI 视频生成,所有零成本起步的路。
如果你从图像的世界来:同一条路已经走过了,起点是免费 AI 图像生成。
来源
- OpenAI,Sora 关闭说明(应用、网站与 API):help.openai.com
- Google Cloud,Gemini Enterprise Agent Platform 价格(Veo 3.1):cloud.google.com
- Google DeepMind,Veo:deepmind.google
- Kling AI,计划与积分:kling.ai
- Higgsfield,计划:higgsfield.ai
- ByteDance Seed,Seedance 2.5:seed.bytedance.com
- Google,Gemini 应用中的视频生成(Gemini Omni):gemini.google
- Kling AI,Kling 4.0 发布说明:kling.ai
- 快手,关于 Kling 4.0 正式上线的新闻稿(2026 年 10 月 19 日):bernama.com
- 欧盟委员会,《人工智能法》第 50 条的透明度义务:digital-strategy.ec.europa.eu
想第一时间看到更新和动态,可以加入我的 Telegram 频道
AI 视频工具的最新消息,我都会先发布在那里。
发表评论
评论会经过审核后才会公开显示。