Zum Inhalt springen
Case Studies
Case Study · Schritt für Schritt

Wie ich einen Trend mit meinen KI-Influencern nachgemacht habe

Ein Reel-Trend mit einem Straßenstand und einem Tanz vor dem Laden. Ich habe ihn mit meinen KI-Influencern anstelle der Personen nachgemacht, mit einem Logo, das ich ausgesucht habe, und mit einem anderen Produkt: Sushi statt Brot. Hier findest du den Ablauf Schritt für Schritt, die Prompts und die Fehler, die ich korrigieren musste.

7 Schritte · 6 Prompts · Higgsfield

Das Projekt in Zahlen und die Tools

Alles, was du brauchst, um es nachzumachen, Bild für Bild.

Schritte
7
Prompts
6
HaupttoolHiggsfield
1

Niveau: Fortgeschritten · Aktualisiert: Oktober 2026

Das Higgsfield-Symbol, ein verschlungener Faden aus einem leuchtenden Kinofilmstreifen: in den Einzelbildern ein Mann mit Zylinder, ein Restaurant am Meer und ein Sonnenuntergang, auf dunkelviolettem Hintergrund
Das Haupttool · Charaktere, Ort und Video

Higgsfield

Genjutsu für die Bewegung.

Affiliate-Link: Wenn du dich darüber anmeldest, bekomme ich eine Provision und du kannst einen Rabatt von bis zu 50 % erhalten, der ab dem Login über den Link 3 Stunden lang gilt (Bedingungen von Higgsfield, sie können sich ändern). Ich nutze Higgsfield jeden Tag und würde es auch sonst empfehlen.

Higgsfield öffnen
In der Praxis

Was du vor dem Nachmachen wissen solltest.

Was du brauchst

Ein Higgsfield-Abo mit Credits, ein Referenzvideo von 4 bis 30 Sekunden und drei oder vier Bilder (Charaktere und Ort). Um die Teile zusammenzufügen, musst du schneiden: Heute kann für einfache Dinge ein kostenpflichtiges Claude oder GPT gute Schnittarbeit leisten, aber für mehr Kontrolle empfehle ich ein Schnittprogramm. Ein beliebiger Computer genügt: Die Generierung läuft online.

Was du ändern kannst

Genjutsu ändert die visuelle Seite und lässt das Video, wie es ist: Bewegung, Kamera und Timing bleiben die der Referenz. Du kannst also das Aussehen von Objekten, Gebäuden, Hintergründen, Schauplätzen und Charakteren nach Belieben ändern.

Kostenlose Alternative

Um die Charaktere und den Ort zu erzeugen, kannst du es mit dem kostenlosen Kontingent eines Bildgenerators versuchen. Um die Bewegung eines Videos auf deine Charaktere zu übertragen, gibt es Wan 2.2 Animate, ein Open-Source-Modell (Apache-2.0-Lizenz), das in ComfyUI läuft: Es ist kostenlos, aber du brauchst eine leistungsstarke Grafikkarte oder ein paar kostenlose Tests in der ComfyUI-Cloud. Ich nutze ComfyUI für andere Arbeiten, aber Wan 2.2 Animate habe ich bei diesem Trend nicht ausprobiert. Die Ergebnisse unterscheiden sich von denen von Genjutsu.

Der Ablauf

Das Video, Bild für Bild zerlegt.

Jedes Bild ist ein Schritt: was ich tue, mit welchem Tool, dazu der echte Prompt zum Kopieren.

Scrollen: ein Bild nach dem anderen.Scrollen: Der Filmstreifen läuft mit. Oder nutze die Marker unten.
Ablauf überspringen

Schritt 01: Der Trend und das Referenzvideo

Auf Papier oder mit einer KI

Ich wähle den Trend aus und notiere, was passiert und wo die Schnitte liegen: Das Referenzvideo bestimmt Bewegung, Kamera und Rhythmus.

Schritt lesen

Der Trend ist der aus den Reels, in denen man durch die Straße läuft, an einem Stand stehen bleibt, in etwas hineinbeißt und dann vor dem Laden tanzt, mit schnellen Schnitten im Takt der Musik. Genjutsu erfindet keine Personen: Es verwandelt die, die im Referenzvideo zu sehen sind. Sind im Video drei Personen, gibt es im Ergebnis drei Charaktere.

Bevor ich generiere, sehe ich mir das Video in Ruhe an und schreibe auf, wer was tut, welche Gesten es gibt und wo die Schnitte liegen: Die Shotlist meines Videos siehst du im Bild dieses Schritts. Genjutsu akzeptiert Referenzen von 4 bis 30 Sekunden: Meine war länger, also habe ich sie an den Schnitten in zwei Teile geteilt, einen von etwa 20 und einen von etwa 14 Sekunden.

Das geht auf zwei Arten. Von Hand: Du siehst dir das Video an und schreibst die Shotlist und den Prompt selbst, das dauert etwa zehn Minuten. Mit einer sehr leistungsstarken, kostenpflichtigen KI (zum Beispiel GPT-6 Astra oder Claude Opus 5.5): Du gibst ihr das Video, bittest sie, die Shotlist und den Prompt zu schreiben, und in wenigen Sekunden hast du einen Entwurf. Die Anfrage, die ich ihr stellen würde, steht im Prompt-Feld: einfach, so wie ich sie einer Person schreiben würde. Meistens sage ich ihr, welcher Charakter im Video durch welches der angehängten Bilder ersetzt werden soll; mit Objekten, Landschaften und allem anderen geht es genauso. Prüfe den Entwurf immer: Bei einer weniger leistungsstarken KI wird die Shotlist falsch, und du merkst es erst nach dem Generieren.

Manche KIs können keine Videos ansehen: Dann lass sie die Einzelbilder selbst extrahieren, eines pro halber Sekunde, mit einem kostenlosen Programm wie ffmpeg. Die Bewegung dieses Videos stammt aus einem Reel, das ich in den sozialen Netzwerken gefunden habe, und ich zeige es hier nicht: Die Shotlist ist aus den Bildern meines Ergebnisses gemacht. Für eine eigene Arbeit ist der sicherste Weg, eine eigene Referenz zu drehen: Mit dem Handy braucht es nur ein paar Minuten für ein paar Sekunden Video. Mit dem Handy lohnt es sich, mehrere Versuche zu machen und den guten zu behalten: Der ist es, den du dann in Genjutsu bringst, um das Video mit deinen KI-Influencern zu machen.
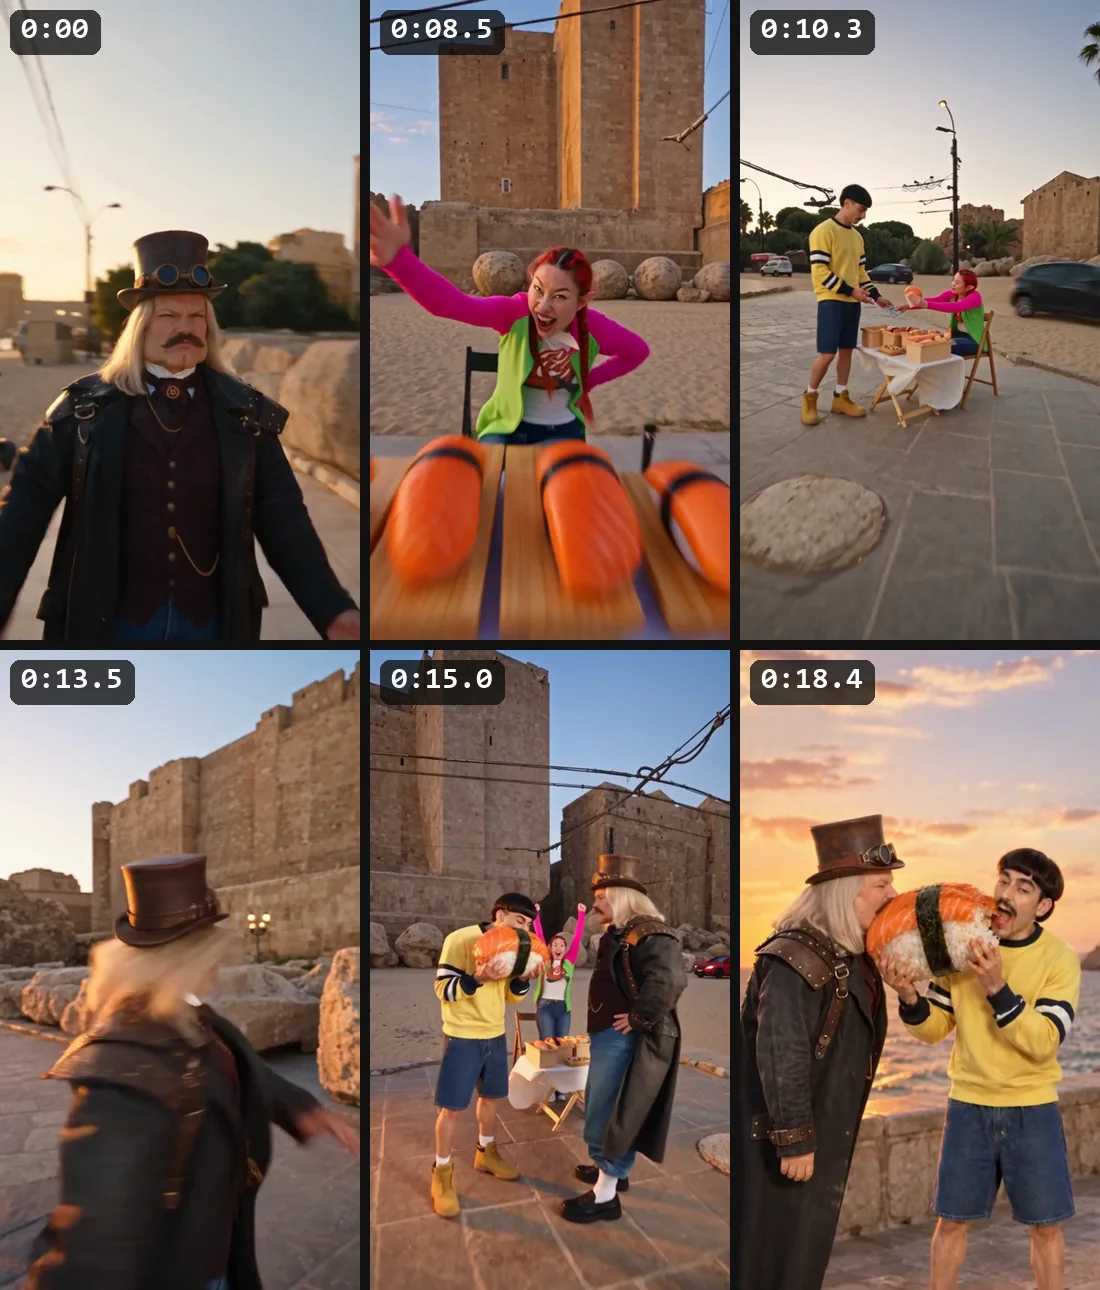
Sechs Einzelbilder des fertigen Videos, eines pro Einstellung, mit der Sekunde, in der jeder Schnitt beginnt
Die Shotlist: sechs der Schnitte des Trends, mit der Sekunde, in der jeder beginnt
Die Anfrage an die KI (ich schreibe sie auf Italienisch; hier übersetzt) · Text
Ich hänge dir ein Reel (@video 1) und vier Bilder an: die Charakterblätter von drei Charakteren (@image 1, @image 2 und @image 3) und den Ort (@image 4). Ich möchte das Reel mit Higgsfield Genjutsu nachmachen, mit meinen Charakteren an meinem Ort und mit einem anderen Produkt: Sushi statt Brot. Ersetze die Frau im schwarzen Top durch @image 1, die Frau mit dem Kopftuch durch @image 2 und den Mann im weißen T-Shirt durch @image 3. Liste die Schnitte mit der Sekunde auf, in der sie liegen, und schreib mir den Prompt für Genjutsu, auf Englisch.

TippNotiere die Schnitte mit der jeweiligen Zeitangabe: Du brauchst sie, um die Stücke im selben Rhythmus wieder zusammenzuschneiden.
Schritt 02: Die Charaktere: ein Blatt pro Person

Charakterblatt

Für jeden Charakter mache ich ein Charakterblatt: ein einziges Bild mit dem Gesicht in Nahaufnahme, der Ganzkörperfigur von vorn und der Ganzkörperfigur von hinten. Bei der Figur von vorn entferne ich den Kopf.

Schritt lesen

Ein KI-Influencer entsteht nicht aus einem einzigen Prompt: Am Anfang steht das Casting. Für dieses Video habe ich drei Charaktere: einen Mann mit Zylinder und Steampunk-Brille, eine Frau mit Elfenohren und roten Zöpfen und einen Mann mit Pagenkopf und Schnurrbart. Jeder Charakter hat sein eigenes Blatt, und jedes Blatt zeigt NUR EINE Person.

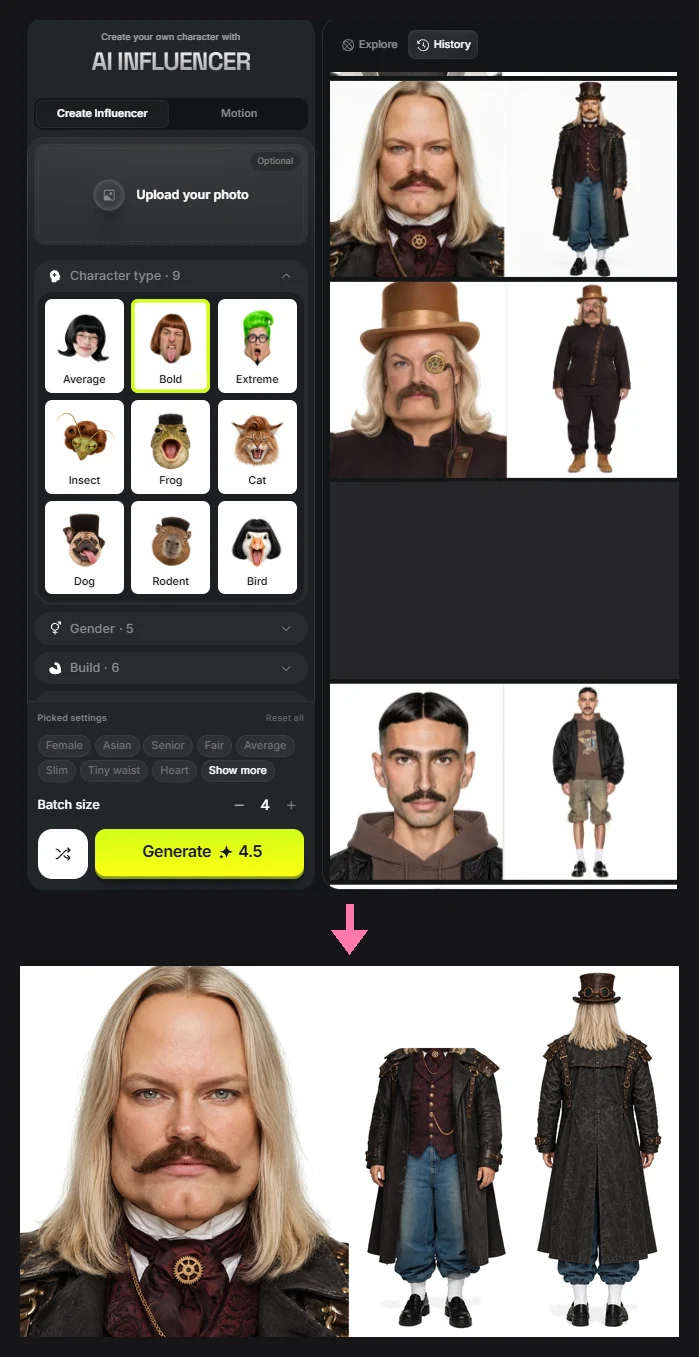
Das Charakterblatt ist ein einziges Bild mit drei Ansichten derselben Person: das Gesicht in Nahaufnahme, die Ganzkörperfigur von vorn und die Ganzkörperfigur von hinten, mit flachem Licht und neutralem Hintergrund. Ich mache es mit dem Tool, mit dem ich am besten zurechtkomme: GPT Image, Seedream oder AI Influencer von Higgsfield, den du im oberen Teil des Screenshots siehst.

AI Influencer geht von einem Charaktertyp und seinen Merkmalen aus (Geschlecht, Statur, Alter, Haare, Augen, Schnurrbart ...) und liefert das Gesicht in Nahaufnahme und die Ganzkörperfigur von vorn. Die Ansicht von hinten ergänze ich mit einem Edit: Ich lade das Blatt als Referenz in GPT Image 2.5 hoch und bitte um denselben Charakter von hinten. Der Prompt steht im Prompt-Feld.

Am Ende entferne ich im Blatt den Kopf der Ganzkörperfigur von vorn und schneide sie unter dem Kinn ab.

Oben das Tool AI Influencer von Higgsfield mit den bereits erzeugten Blättern, unten das fertige Blatt des Steampunk-Mannes: das Gesicht in Nahaufnahme, die Ganzkörperfigur von vorn ohne Kopf und die Ganzkörperfigur von hinten
Oben das Tool AI Influencer, unten das fertige Charakterblatt mit den drei Ansichten
Edit-Prompt für die Ansicht von hinten · Bild
A plain film character sheet photograph of the same adult man as in the reference, now seen from directly behind, full body, standing straight with his arms relaxed at his sides and both feet flat on the ground, the whole body from the top of the hat to the shoes in frame and centered. Same long straight blond hair falling past his shoulders, same brown leather top hat with brass goggles on the band, same long black weathered leather coat with studded leather shoulder pads and buckled straps, same blue baggy trousers gathered above the ankles, white socks and black loafers. Flat soft studio light, plain white seamless background, no styling, unretouched natural photographic look, the same scale and proportions as the full-body figure in the reference.
  • ToolAI Influencer
  • EditGPT Image 2.5, mit dem Blatt als Referenz
  • Format2:3
  • QualitätHoch

TippEntferne bei der Ganzkörperfigur von vorn den Kopf: Nach meiner Erfahrung behält der Charakter so seine Identität besser, weil das Modell nur ein Gesicht sieht, das in Nahaufnahme.

Schritt 03: Der Ort, vorher ausgewählt

Higgsfield · Bild

Der Ort ist ein Bild: Genjutsu baut die Straße des Referenzvideos um genau diesen Ort herum nach.

Schritt lesen

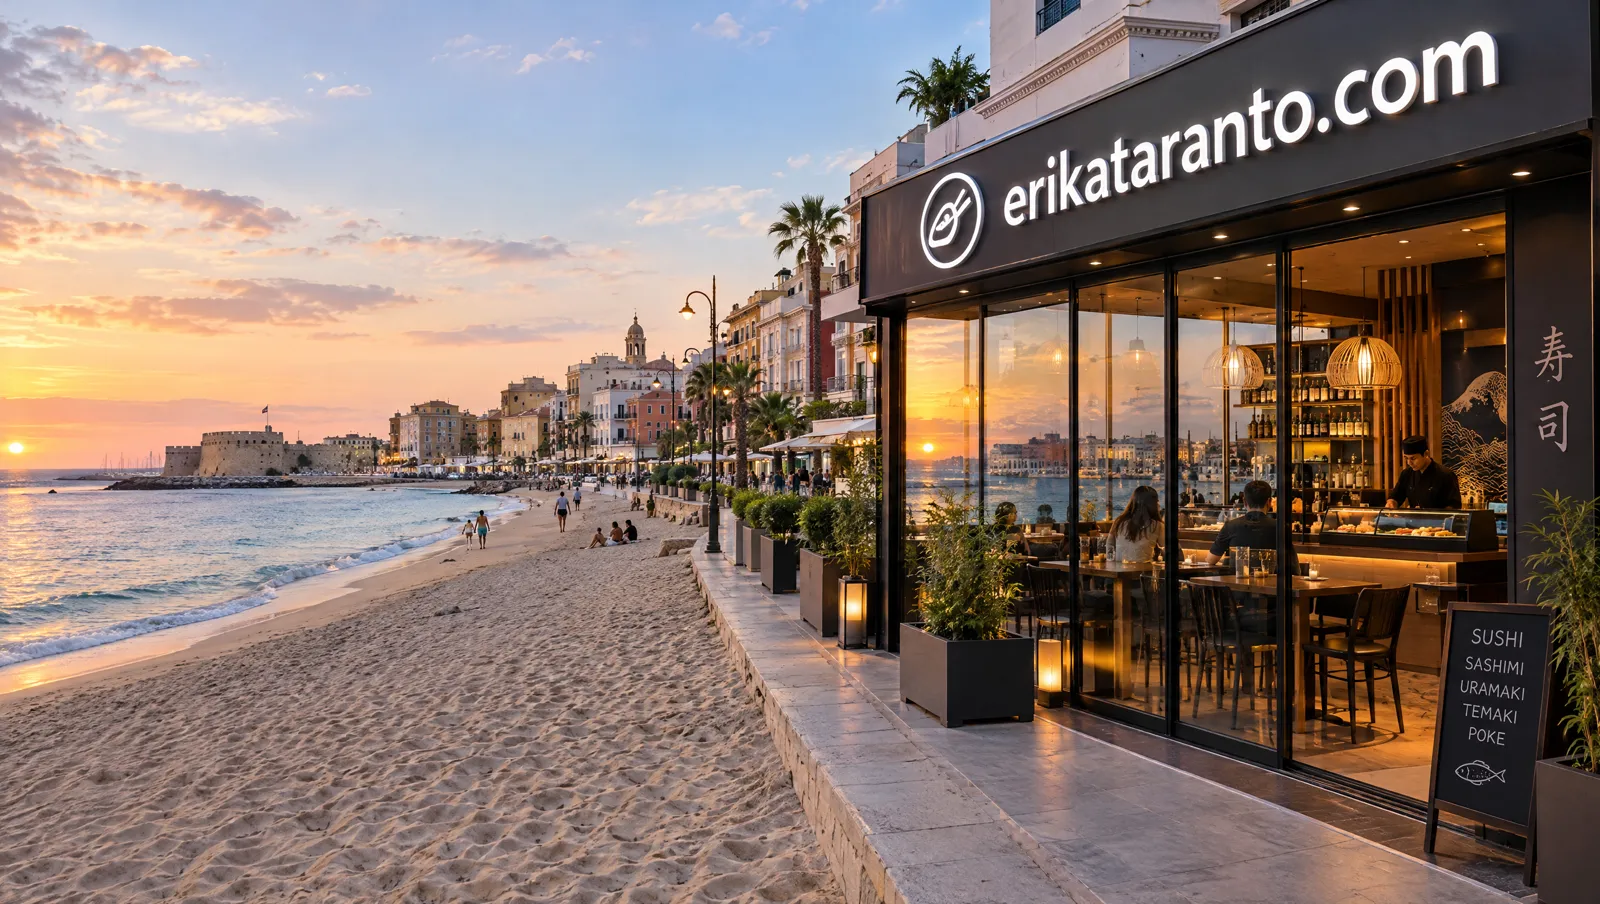
Vor dem Video wähle ich, wo es spielt. Hier ist es eine Strandpromenade bei Sonnenuntergang mit einem Sushi-Restaurant und meinem Schild, erikataranto.com. Der Ort ist das vierte Referenzbild, nach den drei Charakteren.

Für Orte nutze ich GPT Image 2.5: Für das, was ich brauche, und nach meinen Maßstäben ist es sehr gut. Der Prompt war nur ein Test: ein kurzer, einfacher Satz auf Italienisch, um das Tool auszuprobieren. Das Bild ist trotzdem schön geworden, und genau das mag ich an diesem Modell: Andere brauchen nach meiner Erfahrung mehr Details. Also habe ich beschlossen, es zu behalten.

Im Prompt des Videos beschreibe ich den Ort nicht: Ich schreibe, dass Bild 4 der freigegebene Ort ist, und bitte darum, die ganze Straße als genau diesen Ort nachzubauen: das Restaurant anstelle des Geschäfts, der Sand, die Steinpromenade, die Palmen, die Laternen. Steht der Ort schon fest, muss das Modell nichts erfinden.

Strandpromenade bei Sonnenuntergang mit dem Sushi-Restaurant und dem Schild erikataranto.com
Der Referenzort
Der Prompt, den ich geschrieben habe (auf Italienisch; hier übersetzt) · Bild
Stadt in Strandnähe mit Sand, Sushi-Bar in der Nähe mit Glasfenstern und einem Schild mit der Aufschrift "erikataranto.com"
  • ModellGPT Image 2.5
  • Format16:9
  • QualitätHoch · 2K

TippWenn du ein Schild mit einem Namen willst, setze ihn in Anführungszeichen.

Schritt 04: Higgsfield Genjutsu: Die Bewegung geht auf deine Charaktere über

Higgsfield · Genjutsu

Ich lade das Referenzvideo, die Blätter und den Ort hoch und schreibe, wer wen ersetzt. Genjutsu behält Bewegung, Kamera und Timing und baut alles andere neu auf.

Schritt lesen

Ich nutze Genjutsu im Modus Motion Transfer: Das Referenzvideo liefert Bewegung, Kamera und Timing, die Blätter liefern Gesichter und Kleidung, das Bild des Ortes liefert den Ort. Der Prompt sagt, wer wen ersetzt, und beschreibt jede Person so, wie sie im Referenzvideo aussieht, denn das Modell muss sie wiederfinden.

Ich lade das Referenzvideo, die drei Charakterblätter und das Bild des Ortes hoch, das als Hintergrund dient, und schreibe den Prompt. Ich empfehle, direkt in 1080p zu generieren. Das ist der Prompt meines ersten Versuchs; die Beschreibungen der Personen und der Geschäfte stammen aus meiner Referenz, deine werden anders sein. Hier heißen die Referenzen Image 1, Image 2 und Video 1: In meinen neueren Prompts schreibe ich @image 1, @image 2 und @video 1 und schließe mit einer Liste, was jede Datei zeigt.

Wenn du danach 4K willst, gibt es den Video-Upscaler von Higgsfield: Das Video wird schärfer und sauberer, aber es ist nicht dasselbe, wie es direkt in 4K zu generieren, denn der Upscaler fügt Details hinzu, die vorher nicht da waren.

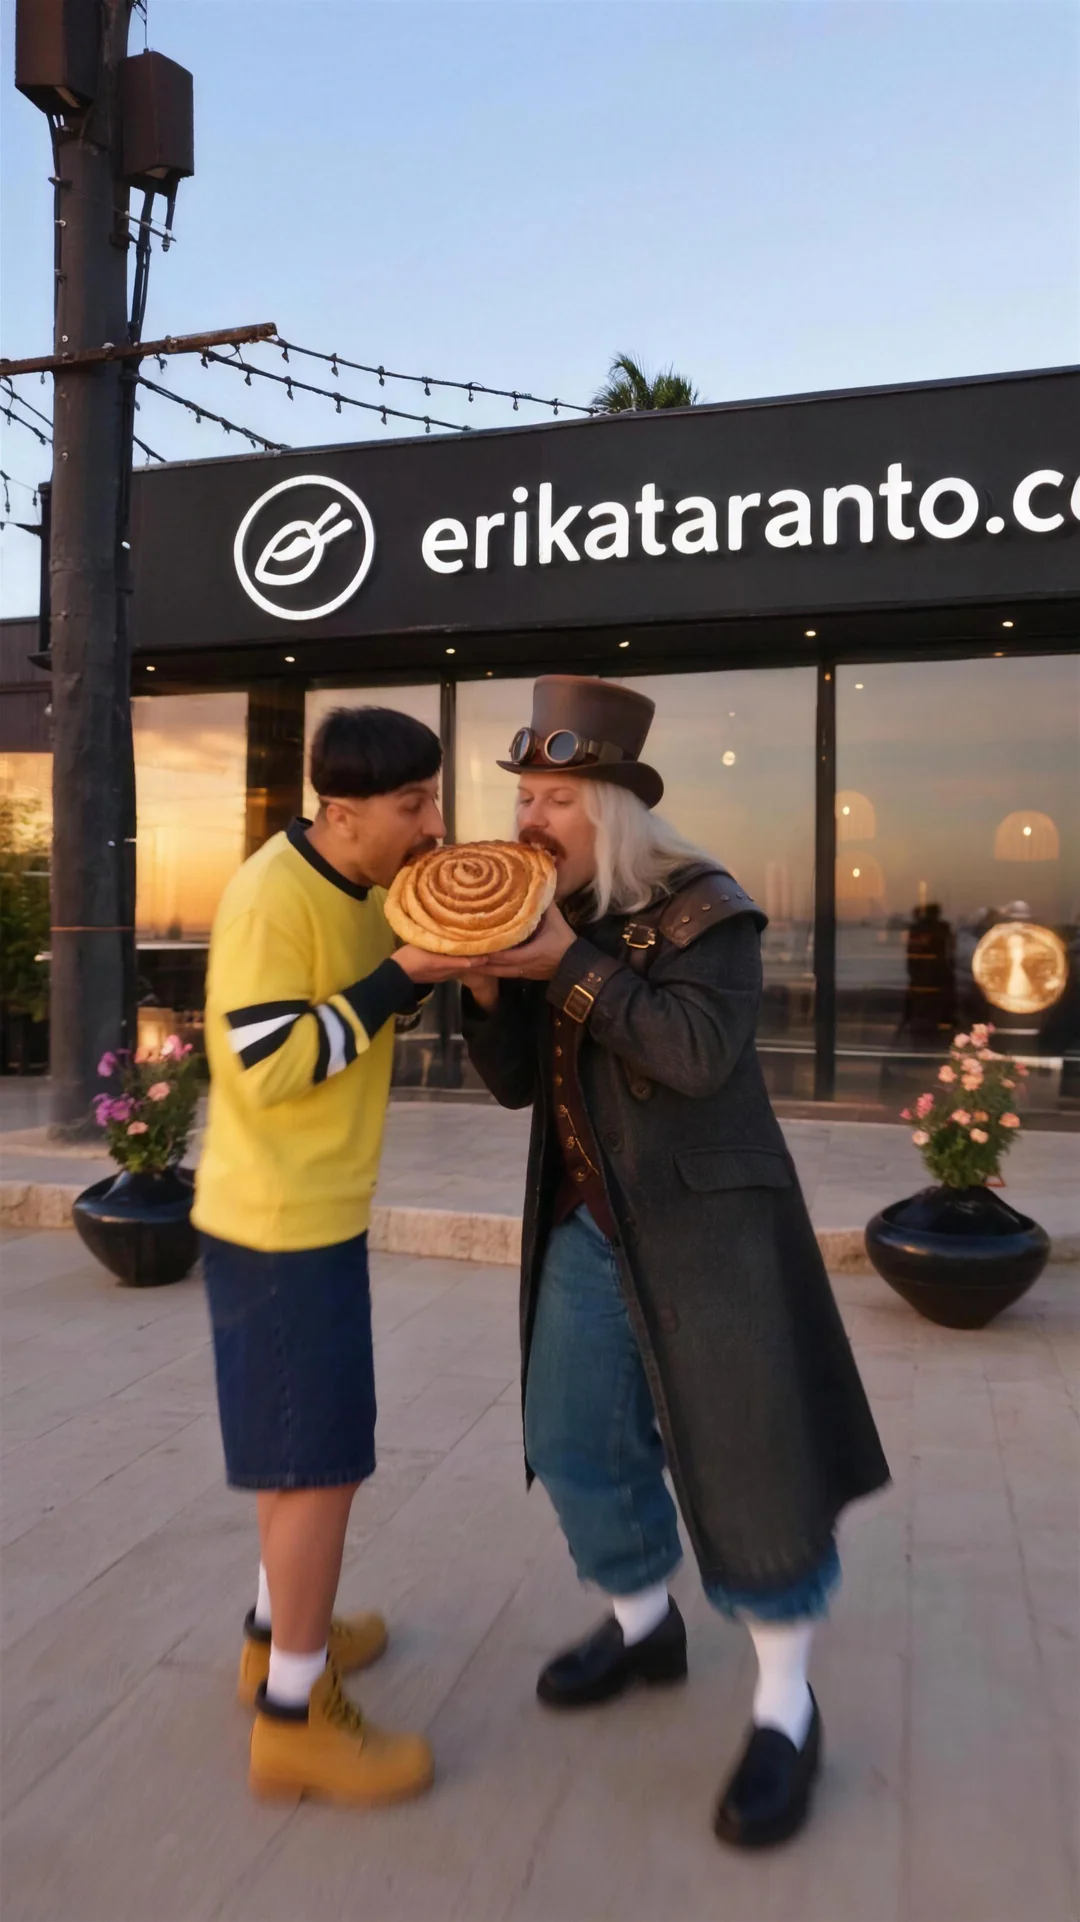
Der erste Versuch kam mit der Bäckerei und dem Brot heraus: Ich hatte nicht daran gedacht, ein Referenzbild für das Sushi zu machen. Das siehst du im nächsten Schritt.

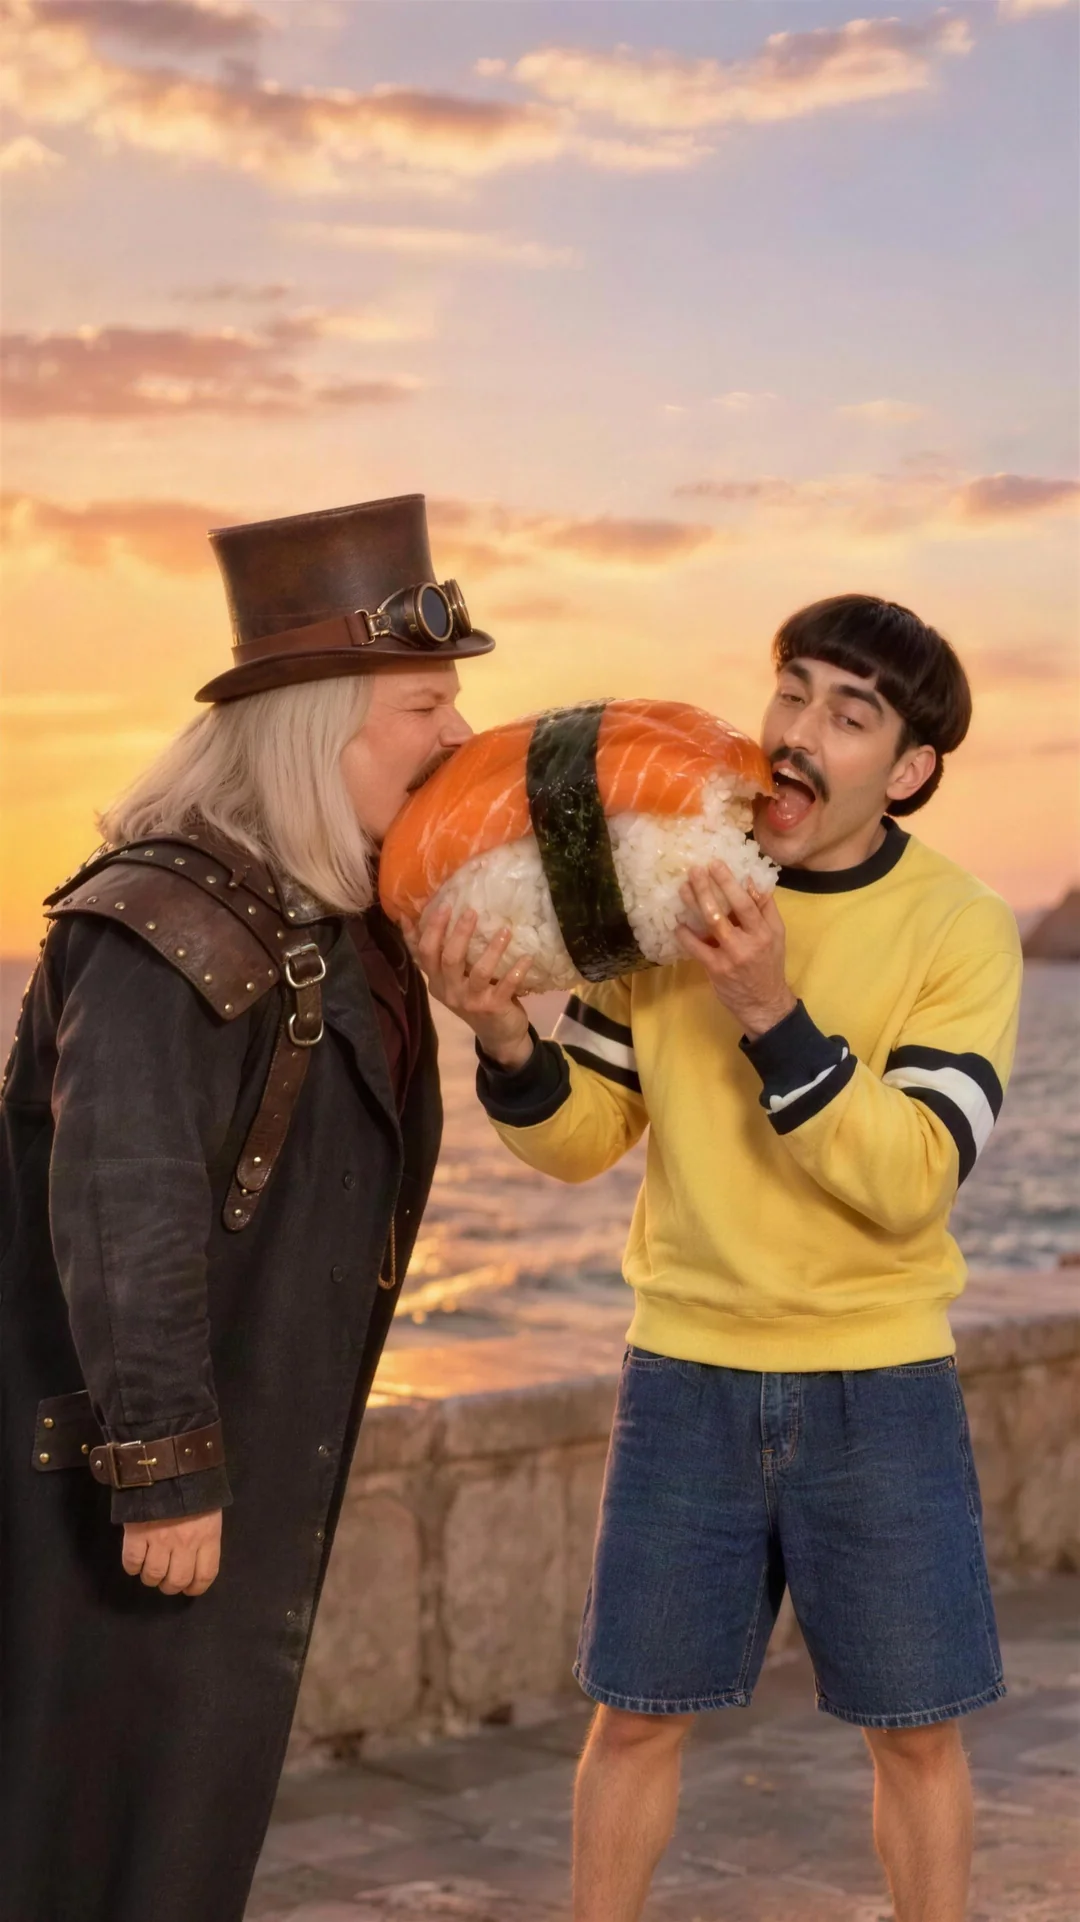
Ein Einzelbild des fertigen Videos: Die beiden Männer beißen gemeinsam in ein riesiges Nigiri, bei Sonnenuntergang an der Strandpromenade
Ein Einzelbild des Ergebnisses
Prompt des ersten Versuchs · Video
Motion-transfer remake of Video 1. Follow the source exactly for shot order, camera movement, timing, body movements, gestures, gaze, facial performance and interactions. Keep the source's low-angle ultra-wide handheld camera with its tilted framings. Rebuild all visible imagery as live-action footage on a seaside promenade at sunset, natural golden-hour light, unretouched skin, realistic pores and hair. CAST MAPPING IS FIXED: Image 1 is one adult man, shown in an identity sheet. Replace the original protagonist, the woman in the black halter vest and wide pink trousers who walks down the street, reacts at the stall, takes the other man by the hand, points to the bakery and leads the dance, with this man in his outfit from the sheet. Image 2 is one adult woman, shown in an identity sheet. Replace the woman in the headscarf and sunglasses who sits at the street stall selling bread with this woman in her outfit from the sheet. Image 3 is one adult man, shown in an identity sheet. Replace the man in the white t-shirt and black shorts who buys and eats the bread with this man in his outfit from the sheet. Keep their faces, hair, outfits and body proportions faithful to the sheets through every angle. Each sheet represents ONE person, not several people or a grid to display. Image 4 is the approved location. Rebuild the entire source street, including the bakery shop that the protagonist points to and dances in front of, as this exact place: the sushi restaurant with its glass front takes the place of the bakery, with the sandy beach, the stone promenade, the palm trees, the lamp posts and the buildings in the distance, under the same low golden light. The street stall with its folding table, white tablecloth, trays of bread and folding chair stands on the promenade in front of the restaurant. Map source floor contacts onto the real paving. Preserve the layout and dimensions consistently as the camera and the people move. Remove the original cars, power cables and buildings. Reconstruct the source signs and text (the bakery sign, the bank sign, the other shop signs, the phone number) as uninterrupted clean scene imagery; the only text in the scene is the sign already in Image 4. Deliver a single full-frame 9:16 live-action-looking video, stable identities, convincing hands, no studio beauty retouching, no trace of the original people. No subtitles, no music, no dialogue. Preserve the source timing and the three-person performance.
  • ModusMotion Transfer
  • Referenzvideo4 bis 30 Sekunden
  • Bilderdie drei Charakterblätter und der Ort (der Hintergrund)
  • Promptder im Prompt-Feld

TippUm eine erwachsene Person zu beschreiben, schreibe ich "woman" und "man" und vermeide "girl", "boy" und "young". Das ist eine Vorsichtsregel von mir: Higgsfield veröffentlicht keine Liste der Wörter, die die Filter blockieren, aber die Filter sind streng, und ich will keine Zweifel am Alter der Charaktere lassen. Wird ein Prompt blockiert, werden die Credits automatisch zurückerstattet. Schreibe nichts, was nicht im Referenzvideo oder in deinen Bildern vorkommt.

Schritt 05: Prüfen und nur die falschen Stellen neu machen

Higgsfield · Genjutsu

Ich sehe mir das Ergebnis im Abstand von einer halben Sekunde Bild für Bild an, markiere die falschen Stellen und generiere nur diese neu.

Schritt lesen

Im ersten Versuch stimmten die Charaktere, aber statt des Sushis gab es Brot: Ich hatte nicht daran gedacht, ein Referenzbild für das Sushi zu machen, und das Modell hat das Brot aus dem Originalvideo behalten. In diesem Schritt siehst du den ersten Versuch und das fertige Video.

Um die Fehler zu finden und zu beschreiben, gibt es zwei Wege. Von Hand: Du siehst dir die Einzelbilder an und schreibst die Sekunde jedes Fehlers auf und was an seiner Stelle sein sollte. Mit einer sehr leistungsstarken, kostenpflichtigen KI: Du gibst ihr das Video und nennst ihr die Stelle, die dir nicht gefällt (zum Beispiel „bei 15 Sekunden beißt der Mann ins Brot statt ins riesige Sushi: schreib den Absatz des Prompts neu, der das korrigiert“), und sie schreibt den Absatz neu. Ist die KI nicht leistungsstark genug, lieber von Hand: Ein falscher Prompt führt nur dazu, dass du umsonst neu generierst.

Zur Korrektur habe ich zwei neue Bilder erstellt: ein riesiges Nigiri und den Charakter, der hineinbeißt. Ich habe sie zu den Referenzen hinzugefügt und dem Prompt einen Absatz hinzugefügt, der sagt, welches das einzig erlaubte Essen ist, und Brot und alles andere ausdrücklich verbietet.

Alles neu zu generieren hätte auch die schon guten Stellen wieder aufs Spiel gesetzt, also habe ich nur die falschen neu gemacht: drei Segmente des Referenzvideos, mit mehreren Varianten, insgesamt sieben. Ich habe die beste Variante jeder Stelle ausgewählt und an den Schnitten der Referenz wieder zusammengesetzt. Der Absatz im Prompt-Feld ist der, den ich dem Prompt von Schritt 4 hinzugefügt habe, um den Biss neu zu machen: Der Rest des Prompts ist derselbe.

Der erste Versuch, mit der Bäckerei, und das fertige Video, mit dem Sushi
Der dem Prompt hinzugefügte Absatz · Video
THE ONLY FOOD IS THE GIANT SUSHI: Image 5 is the giant sushi, one gigantic salmon nigiri as big as a head; use only the sushi itself, not the hands holding it. Image 6 shows exactly how the man from Image 3 bites it. On the street stall the table holds only giant nigiri like Image 5 on wooden boards. The woman at the stall hands the man a giant nigiri like Image 5 and he pays. In the eating shot the man from Image 3 holds the giant nigiri from Image 5 with both hands, as big as his head and clearly visible in every frame, and bites a corner of it, exactly like in Image 6: with the same timing as each bite in the source, the rice crumbles and the soy sauce drips down his chin and his hands. No bread, no croissants, no pastry, no fruit, no small round orange balls, no cream, and no bottles, jars, tubes or sauce dispensers anywhere.
  • Neu gemachte Stellen3 Segmente, 7 Varianten
  • Neue Bilderdas riesige Nigiri und der Charakter, der hineinbeißt

TippSieh dir das Video Bild für Bild im Abstand einer halben Sekunde an, nicht nur als Vorschaubild: Die Fehler stecken in den kleinen Details.

Schritt 06: Ton und Schnitt

Schnitt

Genjutsu behält den Ton des Referenzvideos, falls es einen hat. Ich setze die Teile an den Schnitten der Referenz wieder zusammen und prüfe immer, ob der Clip Ton hat.

Schritt lesen

Genjutsu behält den Ton des Referenzvideos, falls die Referenz einen hat. Prüfe vor dem Schnitt immer, ob der heruntergeladene Clip Ton hat.

Ich setze die Teile in der Reihenfolge der Referenz zusammen, entlang ihrer Schnitte, und beschleunige oder verlangsame jedes Stück, damit der Rhythmus wieder der des Trends ist: Das Modell verlängert die Clips auf ganze Sekunden.

Zur Musik: In den sozialen Netzwerken wählst du den Sound am besten beim Veröffentlichen aus der Bibliothek der Plattform. Auf einer Website oder anderswo brauchst du eigene Musik oder eine klare Lizenz: Die Musik des Trends gehört mir nicht, deshalb hat das Video auf dieser Seite keinen Ton.

AudioSchnitt
  • Tonvon der Referenz übernommen, falls vorhanden
  • Schnittan den Schnitten der Referenz
  • Musikaus der Bibliothek des Netzwerks oder lizenziert

Schritt 07: Bonus: dasselbe Video in einem anderen Stil

Higgsfield · Genjutsu Styles

Genjutsu zeichnet dein Video in einem anderen Stil neu (Cartoon, gestrickte Wolle ...) und behält Bewegungen und Einstellungen. Den Übergang vom Normalen zum Stil machst du im Schnitt.

Schritt lesen

Genjutsu überträgt nicht nur die Bewegung auf deine Charaktere. Es gibt auch Styles: Du wählst einen Look, zum Beispiel 2D-Cartoon, Anime, Stop-Motion-Filzpuppen oder „Knitted Yarn World“ (eine Welt aus gestrickter Wolle), und Genjutsu zeichnet jedes Einzelbild deines Videos in diesem Stil neu und behält Bewegung, Kamera und Einstellungen so, wie du sie gedreht hast.

Es akzeptiert Videos von 4 bis 30 Sekunden. Bei den Styles kannst du Referenzbilder hinzufügen (deine Charaktere, ein Produkt, die Kleidung) und einen kurzen, optionalen Prompt, der sagt, was erkennbar bleiben soll (Haare, Hut, Kleidung). Du wählst auch die Auflösung: Wie immer empfehle ich 1080p.

Als Beispiel habe ich die ersten 4 Sekunden meines Videos genommen, mit dem Steampunk-Mann, der geht, und sie durch den Stil Knitted Yarn World laufen lassen.

Genjutsu wendet den Stil auf das ganze Video an, vom ersten bis zum letzten Einzelbild. Den Übergang vom Normalen zur Wolle, den du im Video siehst, habe ich selbst im Schnitt gemacht, an zwei Videos, einem Original und einem aus Wolle.

Dieselbe Bewegung in zwei Stilen: Eine Fadennaht steigt von unten auf und enthüllt die Version aus Wolle
Prompt des Stils · Video
Keep the man's long blond hair, brown leather top hat with goggles and long black leather coat, now made entirely of knitted yarn. Warm golden sunset light.
  • ToolGenjutsu Styles
  • StilKnitted Yarn World
  • Video4 bis 30 Sekunden
  • Referenzbilderoptional
  • Übergangim Schnitt gemacht
Ende des Filmstreifens

Das Ergebnis

Gleicher Ausgangspunkt. Anderes Niveau.

Version „Falsche Stelle“ Version „Neu gemachte Stelle“ Falsche StelleNeu gemachte Stelle

Ziehe den Regler, um denselben Moment vor und nach der Korrektur zu vergleichen. Die beiden Einzelbilder sind mit dem Upscaler von Higgsfield vergrößert.

Wie möchtest du weitermachen

Selbst machen

Mach es bei dir zu Hause nach

Die Tools, die Prompts und die Schritte stehen oben. Kopieren, einfügen, nachmachen.

  • Higgsfield · Genjutsu für die BewegungCharaktere, Ort und Video

Transparenz. Affiliate-Link: Wenn du dich darüber anmeldest, bekomme ich eine Provision und du kannst einen Rabatt von bis zu 50 % erhalten, der ab dem Login über den Link 3 Stunden lang gilt (Bedingungen von Higgsfield, sie können sich ändern). Ich nutze Higgsfield jeden Tag und würde es auch sonst empfehlen.

Von mir machen lassen

Soll ich es machen?

Ein Video wie dieses für deine Marke? Das mache ich: von der Idee bis zur Lieferung, mit derselben Sorgfalt, die du gerade gesehen hast.

  • Kostenloses Angebot
  • Antwort innerhalb von 48 Stunden
  • Von der Idee bis zur Lieferung
Häufige Fragen

Bevor du loslegst.

Du findest die Antwort nicht? Schreib mir, ich antworte in der Regel innerhalb von 48 Stunden.

Schreib mir
Kann ich das Video einer anderen Person als Referenz verwenden?

Für die Bewegung habe ich ein Reel benutzt, das ich in den sozialen Netzwerken gefunden habe, und ich zeige es hier nicht. Wenn du das Ergebnis veröffentlichst, wird die Referenz zu einer Frage der Rechte: Der sicherste Weg ist, selbst ein Referenzvideo zu drehen, und sei es nur ein zehnsekündiges mit dem Handy.

Wie viele Personen kann ich ins Video einbauen?

So viele, wie im Referenzvideo zu sehen sind: Genjutsu verwandelt, wer da ist, und fügt niemanden hinzu. Ein Prompt mit vier Charakteren funktioniert nur, wenn in der Referenz vier Personen sind.

Warum ist das Video in zwei Teilen?

Genjutsu akzeptiert Referenzen von 4 bis 30 Sekunden. Meine war länger, also habe ich sie an den Schnitten in zwei Teile geteilt und wieder zusammengesetzt.

Hat das Video Ton?

Genjutsu behält den Ton des Referenzvideos, falls es einen hat. Das Video auf dieser Seite hat keinen Ton, weil die Musik des Trends nicht mir gehört.

Und wenn ich ein solches Video für meine Marke will?

Dann mache ich es: Schreib mir über die Kontaktseite, und wir sprechen darüber.

Die nächste Case Study? Deine.

Spot, Mini-Film oder ein KI-Charakter: deiner Marke geben wir dieselbe Sorgfalt, die du gerade gesehen hast. Erstes Gespräch und Angebot, kostenlos.