跳到主要内容
案例研究
案例研究 · 分步详解

我是如何用自己的AI网红复刻一个热门玩法

一个热门的 Reels 玩法:街边的小摊,加上在店门口跳舞。我用自己的 AI 网红代替了原来的真人,用的是我自己选的 logo,还把产品换了:从面包换成寿司。这里有一步一步的完整过程、提示词,以及我不得不纠正的错误。

7 个步骤 · 6 条提示词 · Higgsfield

项目数据与工具

重做它所需的一切,逐帧呈现。

步骤
7
提示词
6
主要工具Higgsfield
1

难度:进阶 · 更新于 2026 年 10 月

Higgsfield 的标志,一条蜿蜒的线,由发光的电影胶片构成:画面里是一位戴礼帽的男人、一家海边餐厅和一轮落日,背景是深紫色
主要工具 · 角色、场景和视频

Higgsfield

用 Genjutsu 做动作。

联盟链接:如果你通过这里注册,我会获得佣金,你则可享受最高 50% 的折扣,自你通过该链接登录起 3 小时内有效(以 Higgsfield 的条款为准,可能会变动)。我每天都在用 Higgsfield,没有这个链接我也会推荐它。

打开 Higgsfield
实用信息

重做之前需要了解的事。

你需要什么

一个有积分的 Higgsfield 订阅,一条 4 到 30 秒的参考视频,以及三到四张图片(角色和场景)。要把各个部分拼起来,需要做剪辑:如今简单的剪辑,付费的 Claude 或 GPT 就能做得很好,但想要更多掌控,我建议用剪辑软件。任何一台电脑都够用:生成是在线上完成的。

你可以改什么

Genjutsu 改变的是视觉部分,视频本身保持原样:动作、镜头和节奏仍然是参考视频的。所以物体、建筑、背景、场景和角色的外观,你都可以随意更改。

免费替代方案

生成角色和场景,可以试试图片生成器的免费额度。要把一段视频的动作移到你的角色上,有 Wan 2.2 Animate,这是一个开源模型(Apache 2.0 许可),可以在 ComfyUI 里运行:它是免费的,但需要一块性能强的显卡,或者在 ComfyUI 云端做几次免费试用。我在其他工作里用 ComfyUI,但没有在这个玩法上试过 Wan 2.2 Animate。它的效果和 Genjutsu 的不一样。

制作过程

这支视频,逐帧拆解。

每一帧就是一个步骤:我做什么、用什么工具,以及可以直接复制的真实提示词。

向下滚动:一帧接一帧。向下滚动:胶片随你前进。也可以使用下方的标记。
跳过制作过程

步骤 01:热门玩法与参考视频

纸上或借助 AI

我先选好玩法,记下发生了什么、剪辑点落在哪里:参考视频决定动作、镜头和节奏。

阅读此步骤

这个玩法就是 Reels 里常见的那种:沿街走,在小摊前停下,咬一口东西,然后在店门口跳舞,镜头随音乐的节奏快速切换。Genjutsu 不会凭空造人:它是把参考视频里的人变成别人。视频里有三个人,结果里就有三个角色。

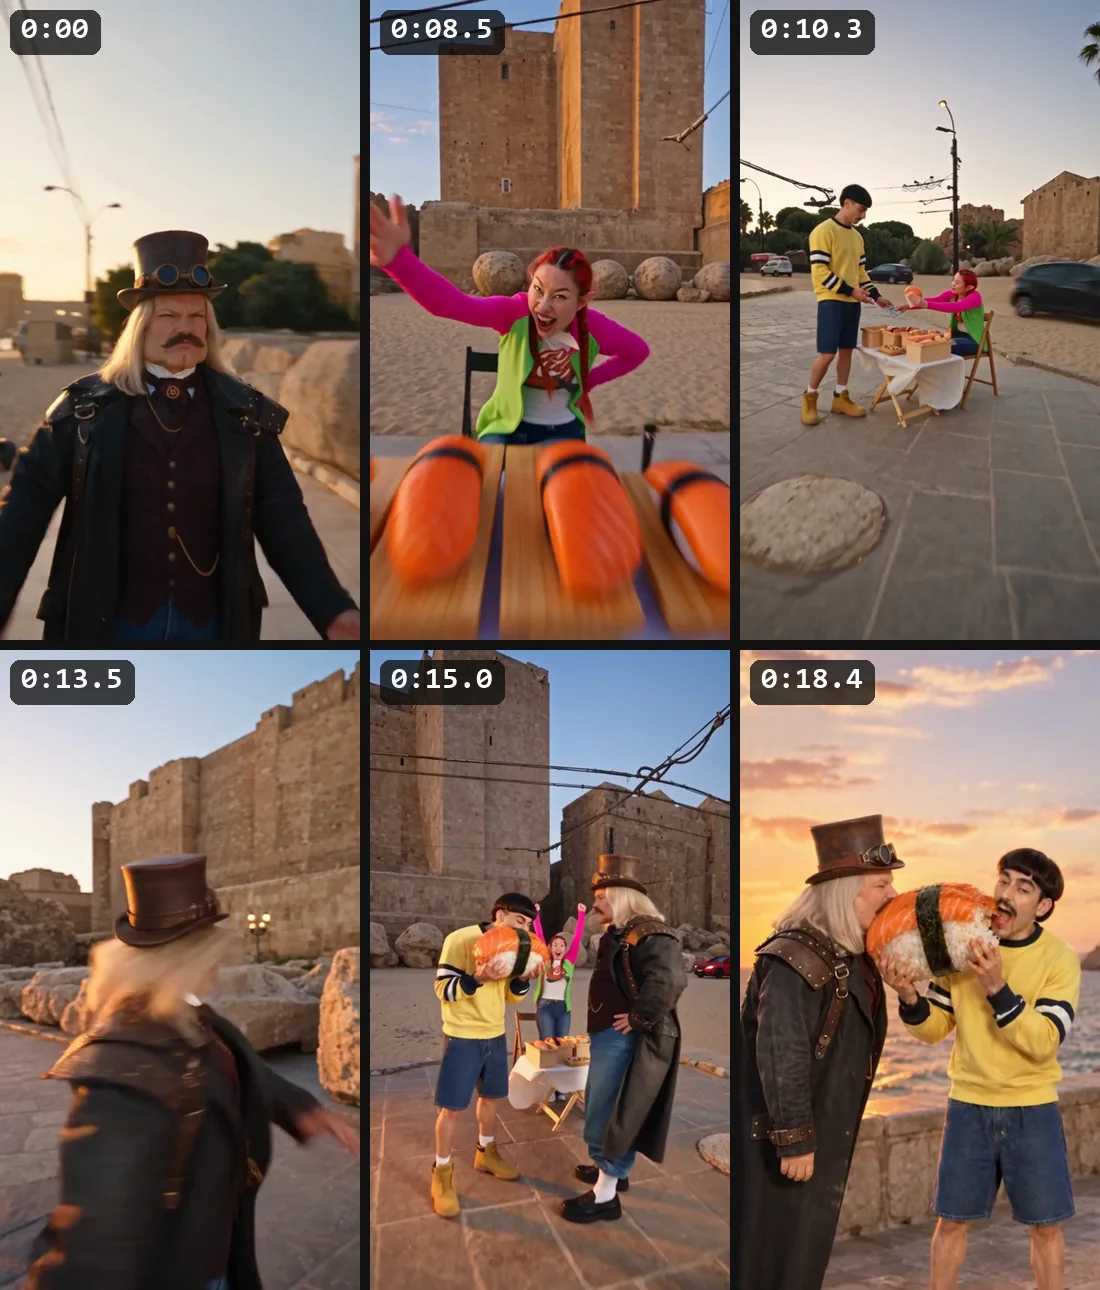
生成之前,我会先仔细看一遍视频,记下谁做了什么、有哪些动作、剪辑点落在哪里:这一步的图片里就是我的分镜表。Genjutsu 接受 4 到 30 秒的参考视频:我的更长,所以我在剪辑点处把它拆成了两段,一段约 20 秒,一段约 14 秒。

有两种做法。手动:你自己看视频,自己写分镜表和提示词,大约需要十分钟。借助功能很强的付费 AI(例如 GPT-6 Astra 或 Claude Opus 5.5):把视频交给它,让它来写分镜表和提示词,几秒钟就能得到一份草稿。我会向它提的请求就在提示词框里:很简单,就像写给一个人那样。我通常会告诉它,视频里的哪个角色要换成我附上的哪张图片;物体、风景和其他一切也是同样的做法。草稿一定要检查:用能力较弱的 AI,分镜表会出错,而你要到生成之后才会发现。

有些 AI 看不了视频:这时可以让它自己提取画面,每半秒一帧,用 ffmpeg 这类免费程序就行。这个视频的动作来自我在社交媒体上找到的一条 Reels,这里不展示它:分镜表是用我自己成片里的画面做的。做你自己的作品时,最稳妥的办法是自己拍一条参考视频:用手机拍几分钟,得到几秒钟的视频就够了。用手机最好多拍几次,留下最好的一条:之后你要带进 Genjutsu、用来制作你的 AI 网红视频的,就是这一条。

成片中的六帧画面,每个镜头一帧,并标出每个剪辑点开始的秒数
分镜表:这个玩法中的六个剪辑点,标出各自开始的秒数
向 AI 提出的请求(我用意大利语写,这里已翻译) · 文字
我附上一条 Reels(@video 1)和四张图片:三个角色的角色设定图(@image 1、@image 2 和 @image 3)以及场景(@image 4)。我想用 Higgsfield Genjutsu 复刻这条 Reels,让我的角色出现在我的场景里,并换一个产品:用寿司代替面包。把穿黑色上衣的女人换成 @image 1,把戴头巾的女人换成 @image 2,把穿白色 T 恤的男人换成 @image 3。请列出每个剪辑点以及它出现的秒数,并用英文为我写一份 Genjutsu 的提示词。

建议记下每个剪辑点的时间:之后要按同样的节奏把各段重新剪回去,就靠它们。

步骤 02:角色:每个人一张设定图

角色设定图

我为每个角色做一张角色设定图:只有一张图,包含近景脸部、正面全身和背面全身。正面全身那张,我会去掉头部。

阅读此步骤

AI 网红不是靠一条提示词诞生的:要先选角。这个视频里我有三个角色:一个戴礼帽和蒸汽朋克护目镜的男人,一个长着精灵耳朵、扎红色辫子的女人,一个留着波波头和小胡子的男人。每个角色都有自己的设定图,每张设定图只显示一个人。

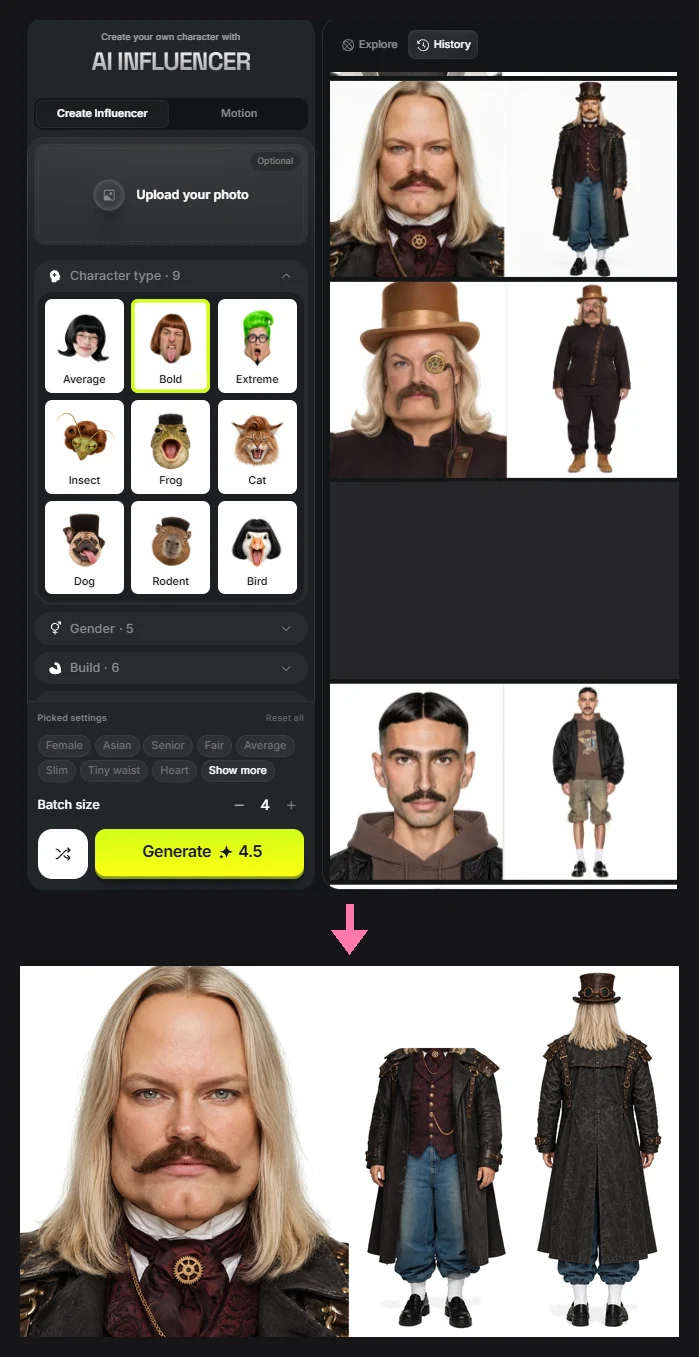
角色设定图就是一张图,里面是同一个人的三个视角:近景脸部、正面全身和背面全身,平光照明、中性背景。我用自己用得最顺手的工具来做:GPT Image、Seedream,或者 Higgsfield 的 AI Influencer,你可以在这一步图片的上半部分看到它。

AI Influencer 从角色类型和它的特征出发(性别、体型、年龄、头发、眼睛、胡子……),给出近景脸部和正面全身。背面视角我用编辑功能来补:把设定图作为参考上传到 GPT Image 2.5,要求生成同一个角色的背面。提示词就在提示词框里。

最后,在设定图里,我把正面全身那张的头部去掉,在下巴以下切掉。

上方是 Higgsfield 的 AI Influencer 工具,里面是已生成的设定图;下方是蒸汽朋克男人的最终设定图:近景脸部、没有头部的正面全身和背面全身
上方是 AI Influencer 工具,下方是包含三个视角的最终角色设定图
背面视角的编辑提示词 · 图片
A plain film character sheet photograph of the same adult man as in the reference, now seen from directly behind, full body, standing straight with his arms relaxed at his sides and both feet flat on the ground, the whole body from the top of the hat to the shoes in frame and centered. Same long straight blond hair falling past his shoulders, same brown leather top hat with brass goggles on the band, same long black weathered leather coat with studded leather shoulder pads and buckled straps, same blue baggy trousers gathered above the ankles, white socks and black loafers. Flat soft studio light, plain white seamless background, no styling, unretouched natural photographic look, the same scale and proportions as the full-body figure in the reference.
  • 工具AI Influencer
  • 编辑GPT Image 2.5,以设定图作参考
  • 比例2:3
  • 质量高

建议把正面全身那张的头部去掉:据我的经验,这样角色更能保持身份,因为模型只看到一张脸,就是那张近景。

步骤 03:场景,先选好

Higgsfield · 图片

场景是一张图片:Genjutsu 会围绕这个确切的地点,重建参考视频里的街道。

阅读此步骤

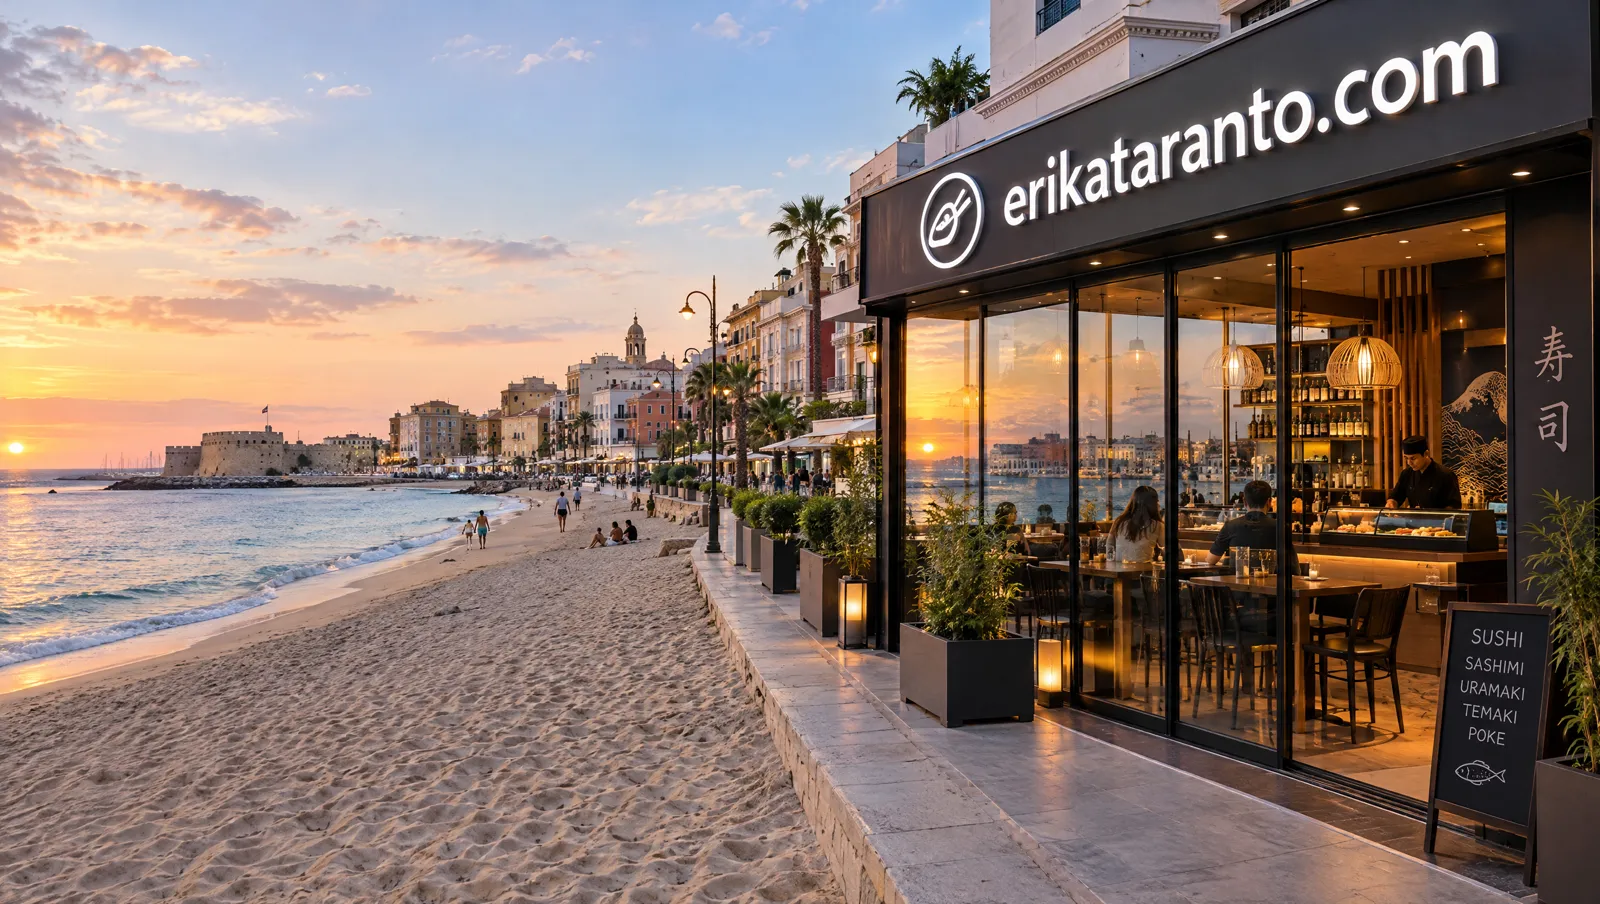
做视频之前,我先选定故事发生在哪里。这里是日落时分的海滨大道,有一家寿司餐厅,还有我的招牌:erikataranto.com。场景是第四张参考图,排在三个角色之后。

做场景我用 GPT Image 2.5:就我的需求和我的标准来说,它非常好。这条提示词只是一次测试:一句简短、简单的意大利语,用来试试这个工具。图片照样出得很漂亮,这也是我喜欢这个模型的地方:据我的经验,其他模型需要更多细节。所以我决定留下它。

在视频的提示词里,我不描述这个地方:我写明图片 4 是已确定的场景,并要求把整条街重建成这个确切的地点:餐厅取代商店,还有沙滩、石头铺的海滨步道、棕榈树和路灯。场景已经定好,模型就不用自己发明任何东西。

日落时分的海滨大道,有寿司餐厅和 erikataranto.com 的招牌
参考场景
我写的提示词(意大利语原文,这里已翻译) · 图片
海滩附近的城市,有沙滩,附近有一家带落地玻璃窗的寿司吧,招牌上写着“erikataranto.com”
  • 模型GPT Image 2.5
  • 比例16:9
  • 质量高 · 2K

建议如果想要一块写着名字的招牌,把名字放在引号里。

步骤 04:Higgsfield Genjutsu:动作传递给你的角色

Higgsfield · Genjutsu

我上传参考视频、设定图和场景,再写明谁替换谁。Genjutsu 保留动作、镜头和节奏,其余的全部重建。

阅读此步骤

我用 Genjutsu 的 Motion Transfer 模式:参考视频提供动作、镜头和节奏,设定图提供脸和服装,场景图片提供地点。提示词要写明谁替换谁,并按每个人在参考视频里的样子来描述,因为模型必须把他们找出来。

我上传参考视频、三张角色设定图和作为背景的场景图片,然后写提示词。我建议直接以 1080p 生成。这是我第一次尝试的提示词;里面对人物和商店的描述来自我自己的参考视频,你的会不一样。这里参考素材叫作 Image 1、Image 2 和 Video 1:在我最近的提示词里,我写 @image 1、@image 2 和 @video 1,并在结尾列出每个文件显示的内容。

如果之后想要 4K,Higgsfield 有视频放大工具:视频会更清晰、更干净,但这和直接生成 4K 不一样,因为放大工具会添加原本不存在的细节。

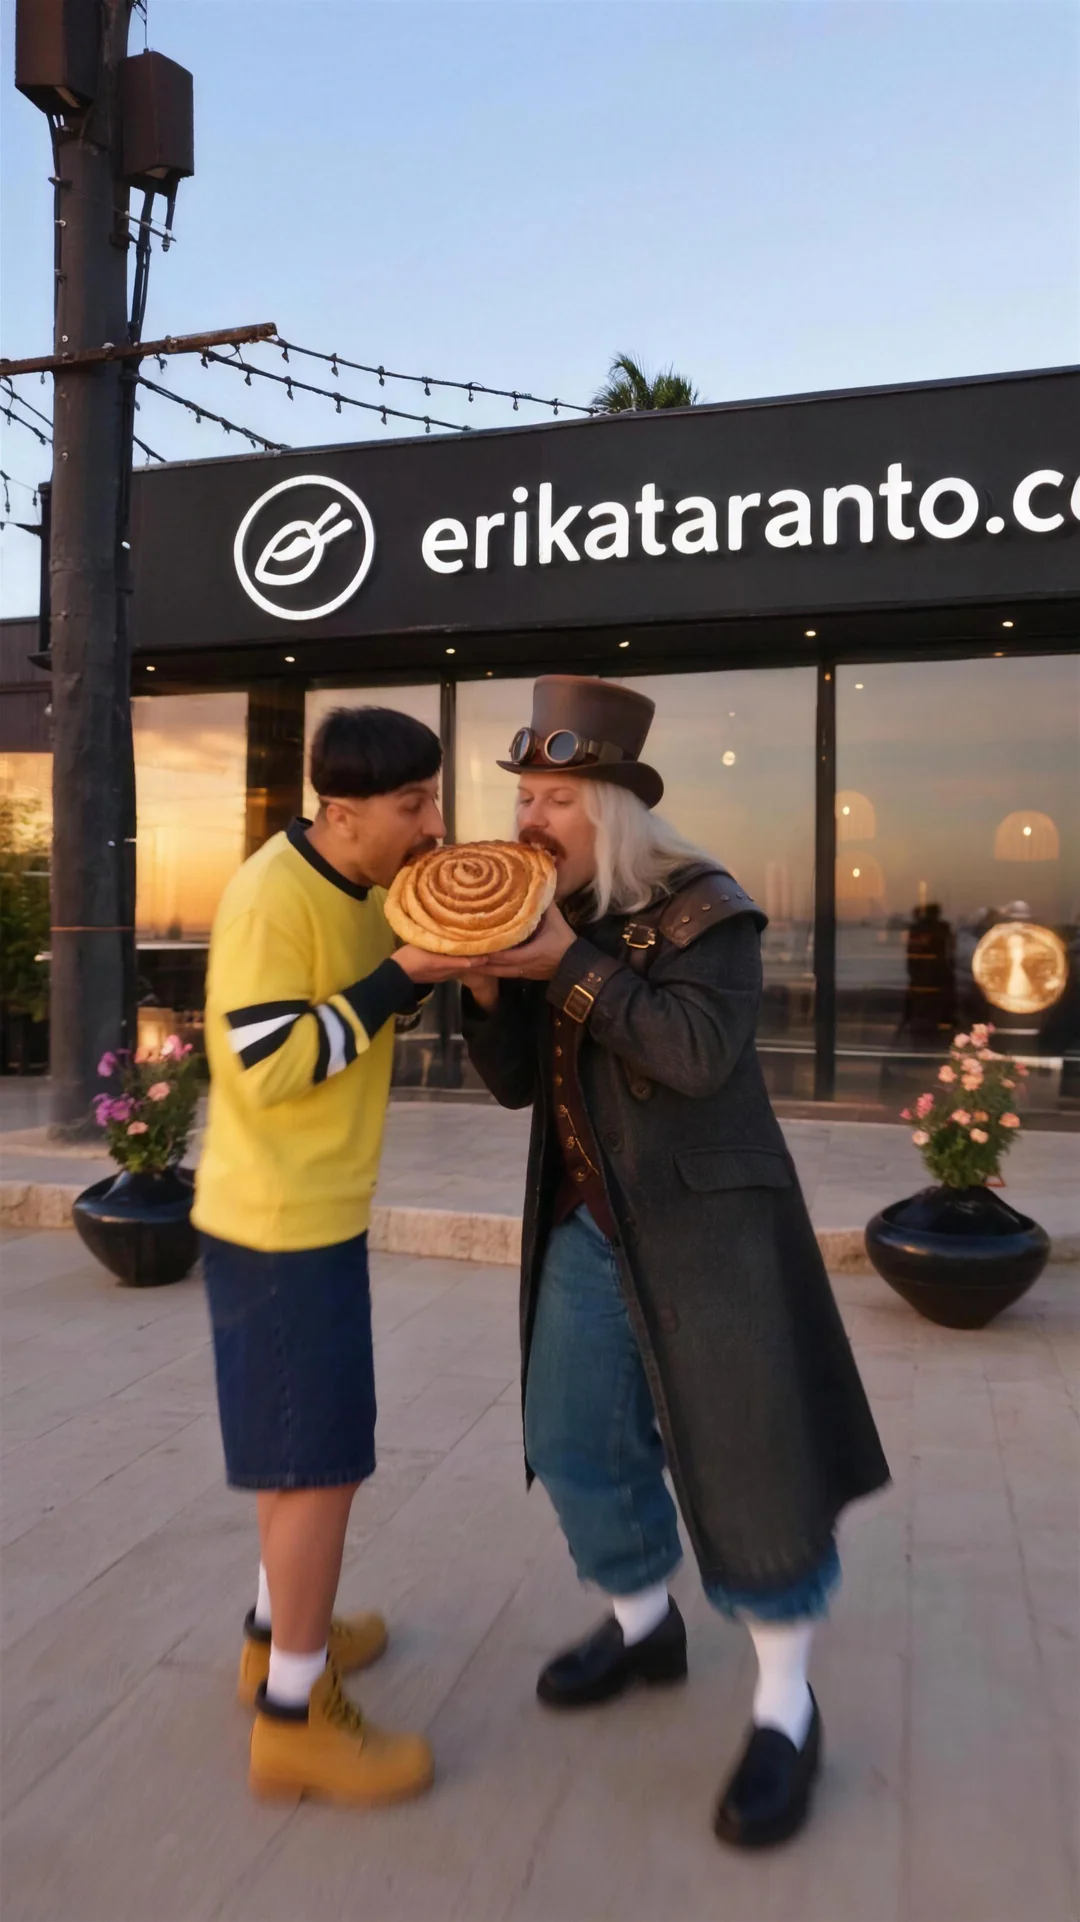
第一次尝试出来的是面包店和面包:我没想到要为寿司做一张参考图。你会在下一步看到。

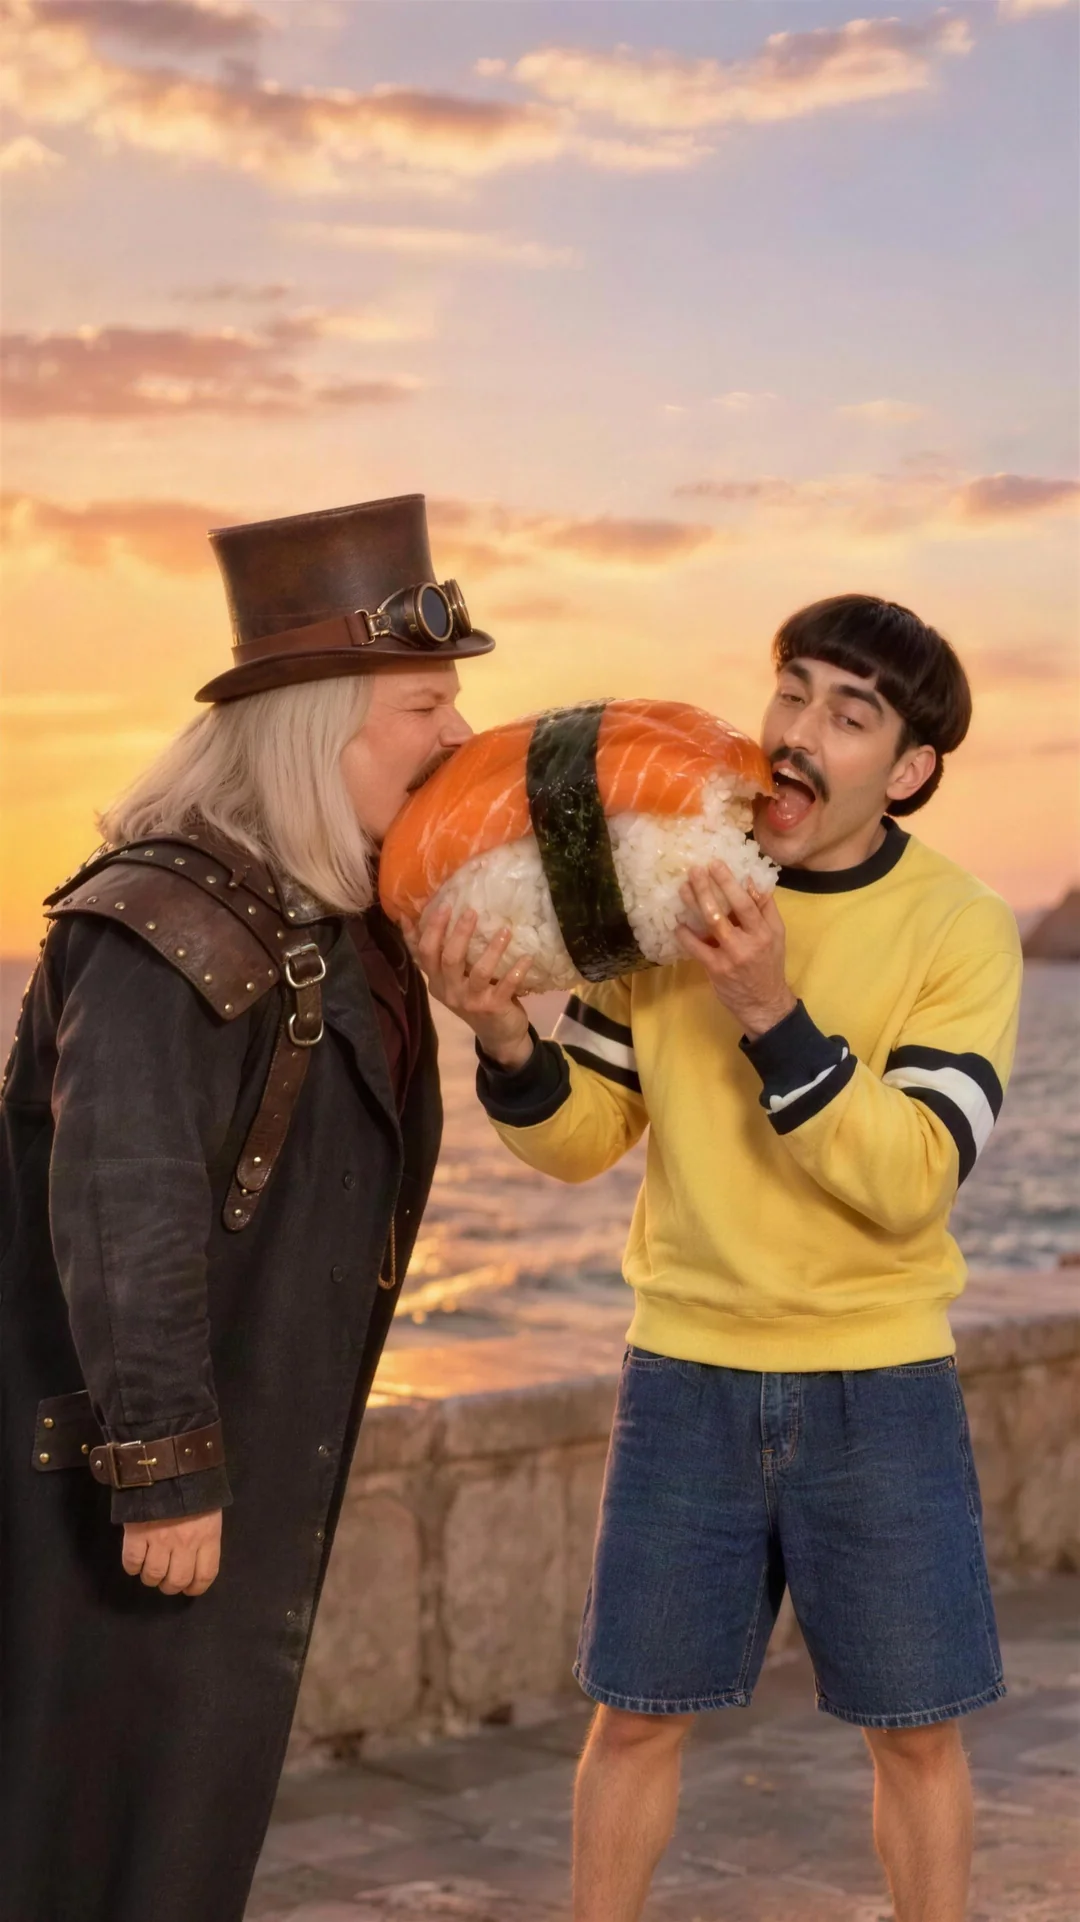
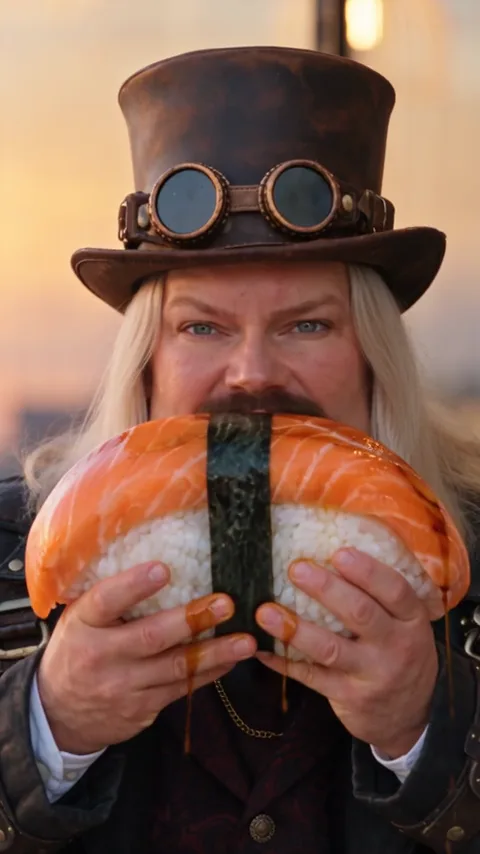
成片中的一帧:两个男人在日落时分的海滨大道上一起咬着一个巨大的握寿司
结果中的一帧
第一次尝试的提示词 · 视频
Motion-transfer remake of Video 1. Follow the source exactly for shot order, camera movement, timing, body movements, gestures, gaze, facial performance and interactions. Keep the source's low-angle ultra-wide handheld camera with its tilted framings. Rebuild all visible imagery as live-action footage on a seaside promenade at sunset, natural golden-hour light, unretouched skin, realistic pores and hair. CAST MAPPING IS FIXED: Image 1 is one adult man, shown in an identity sheet. Replace the original protagonist, the woman in the black halter vest and wide pink trousers who walks down the street, reacts at the stall, takes the other man by the hand, points to the bakery and leads the dance, with this man in his outfit from the sheet. Image 2 is one adult woman, shown in an identity sheet. Replace the woman in the headscarf and sunglasses who sits at the street stall selling bread with this woman in her outfit from the sheet. Image 3 is one adult man, shown in an identity sheet. Replace the man in the white t-shirt and black shorts who buys and eats the bread with this man in his outfit from the sheet. Keep their faces, hair, outfits and body proportions faithful to the sheets through every angle. Each sheet represents ONE person, not several people or a grid to display. Image 4 is the approved location. Rebuild the entire source street, including the bakery shop that the protagonist points to and dances in front of, as this exact place: the sushi restaurant with its glass front takes the place of the bakery, with the sandy beach, the stone promenade, the palm trees, the lamp posts and the buildings in the distance, under the same low golden light. The street stall with its folding table, white tablecloth, trays of bread and folding chair stands on the promenade in front of the restaurant. Map source floor contacts onto the real paving. Preserve the layout and dimensions consistently as the camera and the people move. Remove the original cars, power cables and buildings. Reconstruct the source signs and text (the bakery sign, the bank sign, the other shop signs, the phone number) as uninterrupted clean scene imagery; the only text in the scene is the sign already in Image 4. Deliver a single full-frame 9:16 live-action-looking video, stable identities, convincing hands, no studio beauty retouching, no trace of the original people. No subtitles, no music, no dialogue. Preserve the source timing and the three-person performance.
  • 模式Motion Transfer
  • 参考视频4 到 30 秒
  • 图片三张角色设定图和场景(背景)
  • 提示词提示词框里的那一条

建议描述成年人时,我写“woman”和“man”,避免“girl”、“boy”和“young”。这是我自己的谨慎做法:Higgsfield 没有公布过滤器会拦截的词表,但过滤器很严格,我不想让人对角色的年龄产生任何疑问。如果提示词被拦截,积分会自动退回。不要写任何不在参考视频或你的图片里的内容。

步骤 05:检查,并只重做出错的部分

Higgsfield · Genjutsu

我每半秒一帧地检查结果,标出出错的部分,只重新生成这些部分。

阅读此步骤

第一次尝试时,角色是对的,但本该是寿司的地方出现了面包:我没想到要为寿司做一张参考图,模型保留了原视频里的面包。在这一步里,你可以看到第一次尝试和最终视频。

要找出并描述错误,有两种办法。手动:你看画面,写下每个错误出现的秒数,以及那里本该是什么。借助功能很强的付费 AI:把视频交给它,告诉它你不满意的部分(例如“15 秒时男人咬的是面包,而不是巨大的寿司:请重写提示词中用来纠正这一点的段落”),它会重写这一段。如果 AI 的能力不够强,还是手动更好:错误的提示词只会让你白白重新生成。

为了纠正,我做了两张新图片:一个巨大的握寿司,以及咬它的角色。我把它们加到参考素材里,又在提示词里加了一段,说明唯一允许出现的食物是什么,并明确禁止面包和其他一切。

全部重新生成,连已经满意的部分也得重新来过,风险太大,所以我只重做出错的:参考视频的三个片段,每段生成多个版本,一共七个。我选出每个片段里最好的版本,按参考视频的剪辑点重新拼回去。提示词框里的这一段,是我为重做那一口而加到第 4 步提示词里的:提示词的其余部分是一样的。

第一次尝试(面包店)和最终视频(寿司)
加入提示词的那一段 · 视频
THE ONLY FOOD IS THE GIANT SUSHI: Image 5 is the giant sushi, one gigantic salmon nigiri as big as a head; use only the sushi itself, not the hands holding it. Image 6 shows exactly how the man from Image 3 bites it. On the street stall the table holds only giant nigiri like Image 5 on wooden boards. The woman at the stall hands the man a giant nigiri like Image 5 and he pays. In the eating shot the man from Image 3 holds the giant nigiri from Image 5 with both hands, as big as his head and clearly visible in every frame, and bites a corner of it, exactly like in Image 6: with the same timing as each bite in the source, the rice crumbles and the soy sauce drips down his chin and his hands. No bread, no croissants, no pastry, no fruit, no small round orange balls, no cream, and no bottles, jars, tubes or sauce dispensers anywhere.
  • 重做的部分3 个片段,7 个版本
  • 新图片巨大的握寿司和咬它的角色

建议要每半秒一帧地看视频,不要只看缩略图:错误藏在小细节里。

步骤 06:声音与剪辑

剪辑

如果参考视频有声音,Genjutsu 会保留。我按参考视频的剪辑点把各段重新拼好,并且总是检查片段有没有声音。

阅读此步骤

如果参考视频有声音,Genjutsu 会保留。剪辑之前,一定要检查你下载的片段有没有声音。

我按参考视频的顺序、沿着它的剪辑点重新拼接各个部分,并把每一段加速或减速,让节奏回到这个玩法原来的样子:模型会把片段时长延长到整秒。

关于音乐:发布到社交平台时,最好在平台的音乐库里选声音。放在网站或其他地方,则需要你自己的音乐或授权清晰的音乐:这个玩法的音乐不是我的,所以这一页的视频没有声音。

音频剪辑
  • 声音保留参考视频的声音(如果有)
  • 剪辑按参考视频的剪辑点
  • 音乐来自社交平台的音乐库,或有授权的音乐

步骤 07:加餐:同一个视频,换一种风格

Higgsfield · Genjutsu Styles

Genjutsu 把你的视频重绘成另一种风格(卡通、毛线编织……),并保留动作和镜头。从正常到风格的过渡,在剪辑里完成。

阅读此步骤

Genjutsu 不只是把动作传给你的角色。它还有 Styles(风格):你选一种外观,比如 2D 卡通、动漫、定格动画的毛毡玩偶,或者“Knitted Yarn World”(毛线编织的世界),Genjutsu 就会用这种风格重绘你视频的每一帧,并保持动作、镜头和构图和你拍的一样。

它接受 4 到 30 秒的视频。在 Styles 里,你可以添加参考图片(你的角色、一个产品、服装),还可以写一条简短的、可选的提示词,说明哪些要保持可辨认(头发、帽子、服装)。分辨率也由你选:和往常一样,我建议 1080p。

作为例子,我取了我视频的前 4 秒,也就是蒸汽朋克男人走路的那一段,用 Knitted Yarn World 风格处理了一遍。

Genjutsu 会把风格应用到整个视频,从第一帧到最后一帧。你在视频里看到的从正常到毛线的过渡,是我自己在剪辑里做的,用的是两个视频:一个原版,一个毛线版。

同一个动作,两种风格:一道缝线从下方升起,露出毛线版
风格的提示词 · 视频
Keep the man's long blond hair, brown leather top hat with goggles and long black leather coat, now made entirely of knitted yarn. Warm golden sunset light.
  • 工具Genjutsu Styles
  • 风格Knitted Yarn World
  • 视频4 到 30 秒
  • 参考图片可选
  • 过渡在剪辑里完成
胶片的尽头

成片

同一个起点,不同的高度。

“出错的部分”版本 “重做的部分”版本 出错的部分重做的部分

拖动滑块,对比修正前后的同一瞬间。这两帧用 Higgsfield 的放大工具放大过。

你想怎么继续

自己来

在家重做

工具、提示词和步骤都在上方。复制、粘贴、重做。

  • Higgsfield · 用 Genjutsu 做动作角色、场景和视频

透明声明。联盟链接:如果你通过这里注册,我会获得佣金,你则可享受最高 50% 的折扣,自你通过该链接登录起 3 小时内有效(以 Higgsfield 的条款为准,可能会变动)。我每天都在用 Higgsfield,没有这个链接我也会推荐它。

交给我

想让我来做吗?

想为你的品牌做一支这样的视频?我来做:从创意到交付,用你刚刚看到的同样用心。

  • 免费报价
  • 48 小时内回复
  • 从创意到交付
常见问题

开始之前。

没找到答案?给我留言,我通常在 48 小时内回复。

给我留言
我可以用别人的视频当参考吗?

动作部分我用的是在社交媒体上找到的一条 Reels,这里不展示它。如果你发布结果,参考视频就成了版权问题:最稳妥的办法是自己拍一条参考视频,哪怕只是用手机拍十秒钟。

视频里可以放几个人?

参考视频里有几个人就是几个:Genjutsu 转换的是原有的人,不会新增。提示词里写四个角色,只有在参考视频里确实有四个人时才行得通。

为什么视频分成两段?

Genjutsu 接受 4 到 30 秒的参考视频。我的更长,所以我在剪辑点处把它拆成两段,之后再重新拼起来。

视频有声音吗?

如果参考视频有声音,Genjutsu 会保留。这一页的视频没有声音,因为这个玩法的音乐不是我的。

如果我想为自己的品牌做这样的视频呢?

那就由我来做:通过联系页面给我写信,我们聊聊。

下一个案例?就是你的。

广告、短片或一个 AI 角色:我们为你的品牌投入你刚刚所见的同样用心。首次沟通与报价,免费。